Bạn trò chuyện với AI suốt cả buổi, rồi đột nhiên nó quên mất yêu cầu bạn đưa ra từ đầu, thậm chí báo lỗi. Thủ phạm thường nằm ở context window. Vậy context window là gì? Nói ngắn gọn, context window (cửa sổ ngữ cảnh) là lượng văn bản tối đa mà mô hình AI có thể xem xét cùng lúc trong một lần xử lý, được đo bằng token. Bài viết này giải thích token là gì, điều gì chiếm chỗ trong cửa sổ, vì sao cửa sổ lớn chưa chắc đã tốt hơn, và cách quản lý ngữ cảnh để dùng AI hiệu quả hơn.
Context window là gì?
Để trả lời câu hỏi context window là gì một cách dễ hiểu, hãy bắt đầu từ cách một mô hình ngôn ngữ lớn (LLM) “đọc” yêu cầu của bạn. Mỗi lần trả lời, mô hình không chỉ nhìn vào câu hỏi mới nhất, mà nhìn vào cả một khối văn bản gồm lời nhắc, lịch sử trò chuyện, tài liệu đính kèm và câu trả lời nó đang viết. Khối văn bản đó có kích thước tối đa, và kích thước ấy chính là context window.
Định nghĩa đơn giản: bộ nhớ làm việc ngắn hạn của AI
Có thể hiểu context window là bộ nhớ làm việc ngắn hạn của AI. Mọi thứ nằm trong cửa sổ ngữ cảnh đều được mô hình “nhìn thấy” khi tạo câu trả lời, còn mọi thứ nằm ngoài thì với mô hình coi như không tồn tại. Khi tổng lượng văn bản vượt quá giới hạn, một phần nào đó buộc phải bị cắt bỏ, tóm tắt lại hoặc yêu cầu bị từ chối.
Trong trang hỗ trợ của Gemini, Google dùng một cách diễn đạt rất gần gũi: context window giống như “khả năng đọc” của AI, quyết định lượng nội dung mà nó có thể hiểu cùng một lúc.
Ví dụ so sánh dễ hình dung
Hãy tưởng tượng bạn làm việc trên một mặt bàn có diện tích cố định. Mọi tài liệu, ghi chú và bản nháp đang bày trên bàn, bạn đều có thể liếc nhìn và đối chiếu ngay. Khi bàn đầy, muốn đặt thêm một tờ giấy mới, bạn phải cất bớt tờ cũ vào ngăn kéo. Mặt bàn đó chính là context window, càng rộng thì bày được càng nhiều, nhưng bàn quá bừa bộn thì việc tìm đúng tờ giấy cần thiết cũng khó hơn.
Context window khác gì kiến thức mô hình học lúc huấn luyện
Nhiều người nhầm lẫn hai khái niệm này. Kiến thức huấn luyện là những gì mô hình đã học từ lượng dữ liệu khổng lồ trước khi ra mắt, và dừng lại ở một mốc thời gian gọi là knowledge cutoff. Phần này được “khắc” vào tham số của mô hình và không thay đổi khi bạn trò chuyện. Context window thì ngược lại, nó chứa thông tin của riêng phiên hiện tại, được nạp mới mỗi lần và biến mất khi phiên kết thúc. Nếu kiến thức huấn luyện là học vấn của một chuyên gia, thì context window là tập hồ sơ mà bạn đưa cho họ trong buổi làm việc hôm nay.
Lưu ý: context window trong NLP cổ điển mang nghĩa khác
Trong xử lý ngôn ngữ tự nhiên (NLP) truyền thống, “context window” còn chỉ khoảng vài từ nằm trước và sau một từ đích, dùng để suy ra nghĩa của từ đó. Ví dụ, các phương pháp như Word2Vec học nghĩa của một từ bằng cách xem những từ thường xuất hiện trong cửa sổ vài từ quanh nó. Khi đọc tài liệu cũ hoặc học thuật, bạn nên chú ý phân biệt, vì trong bài này context window luôn mang nghĩa hiện đại gắn với các chatbot AI.
Token là gì và vì sao context window đo bằng token?
Khi đã hiểu context window là gì, câu hỏi tiếp theo là nó được đo bằng đơn vị nào. Câu trả lời là token, và đây cũng là lý do các con số như 128K hay 1M luôn đi kèm chữ “token” chứ không phải “từ” hay “trang”.
Token là gì?
Mô hình AI không đọc văn bản theo từng chữ cái hay từng từ như con người. Trước khi xử lý, văn bản được cắt thành những mẩu nhỏ gọi là token. Một token có thể là cả một từ ngắn, một phần của từ dài, một dấu câu hay một khoảng trắng. Với tiếng Anh, quy tắc ước lượng phổ biến là một token tương đương khoảng ba phần tư từ, tức 1.000 token vào khoảng 750 từ.
Con số này chỉ là trung bình và phụ thuộc vào bộ tách token (tokenizer) của từng hãng. Chẳng hạn, theo tài liệu của Anthropic, bộ tách token mới dùng từ Claude Opus 4.7 khiến 1 triệu token chỉ còn chứa khoảng 555.000 từ tiếng Anh, thay vì khoảng 750.000 từ như các mô hình trước đó. Nói cách khác, cùng một con số token không phải lúc nào cũng chứa cùng một lượng chữ giữa các mô hình.
Lý do các hãng dùng token thay vì từ rất đơn giản: token là đơn vị mà mô hình thực sự xử lý, nên cả giới hạn kỹ thuật lẫn chi phí đều được tính theo nó. Hình ảnh, âm thanh và video khi đưa vào mô hình cũng được quy đổi thành token và thường chiếm nhiều chỗ hơn bạn nghĩ.
Tiếng Việt tốn token hơn tiếng Anh thế nào
Các bộ tách token chủ yếu được tối ưu cho tiếng Anh, nên văn bản tiếng Việt thường tốn nhiều token hơn cho cùng một lượng thông tin. Một phần vì tiếng Việt là ngôn ngữ đơn âm tiết, mỗi từ ghép gồm nhiều âm tiết tách rời; một phần vì các chữ có dấu ít xuất hiện hơn trong dữ liệu xây dựng bộ tách token, nên dễ bị chia nhỏ hơn. Mức chênh lệch thay đổi tùy mô hình và tùy văn bản.
Cách chắc chắn nhất là tự kiểm tra: dán một đoạn tiếng Việt vào công cụ đếm token của hãng bạn đang dùng, chẳng hạn Tokenizer của OpenAI, tính năng đếm token trong Google AI Studio hoặc API đếm token của Anthropic, rồi so với bản tiếng Anh cùng nội dung.
Bảng quy đổi nhanh từ token sang số từ và số trang
Bảng dưới đây dùng quy tắc phổ biến 1 token ≈ 0,75 từ tiếng Anh và khoảng 500 từ mỗi trang. Đây là con số ước lượng, văn bản tiếng Việt và các bộ tách token mới thường chứa ít chữ hơn trong cùng một lượng token.
| Số token | Ước lượng số từ tiếng Anh | Ước lượng số trang | Tương đương |
|---|---|---|---|
| 1.000 | ~750 | ~1,5 | Một bài blog ngắn |
| 32.000 | ~24.000 | ~50 | Một báo cáo dài |
| 128.000 | ~96.000 | ~200 | Một cuốn tiểu thuyết trung bình |
| 200.000 | ~150.000 | ~300 | Một cuốn sách dày |
| 1.000.000 | ~750.000 | ~1.500 | Nhiều cuốn sách, hoặc khoảng 30.000 dòng code |
Mốc 1 triệu token tương đương khoảng 1.500 trang văn bản hoặc 30.000 dòng code cũng là cách Google mô tả cửa sổ ngữ cảnh của Gemini cho người dùng gói trả phí.
Những gì chiếm chỗ trong context window?
Một hiểu lầm phổ biến là context window chỉ chứa câu hỏi bạn vừa gõ. Thực tế, cửa sổ ngữ cảnh phải chứa cùng lúc nhiều thành phần, và nhiều thành phần trong số đó người dùng không hề nhìn thấy.
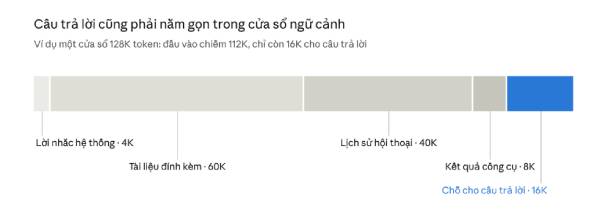
Lời nhắc hệ thống (system prompt). Đây là bộ chỉ dẫn nền do nhà phát triển đặt sẵn: vai trò của trợ lý, giọng văn, quy tắc an toàn, mô tả các công cụ có thể dùng. Bạn không thấy nó, nhưng nó luôn chiếm một phần cố định trong mỗi lần trả lời. Các chỉ dẫn tùy chỉnh như Gem của Gemini hay hướng dẫn dự án cũng thuộc nhóm này.
Toàn bộ lịch sử hội thoại. Mọi tin nhắn của bạn và mọi câu trả lời trước đó của AI đều được đưa lại vào cửa sổ ở mỗi lượt mới. Cuộc trò chuyện càng dài, phần này càng phình to, và đây thường là thành phần tăng nhanh nhất.
Tài liệu và file đính kèm. PDF, bảng tính, đoạn code, hình ảnh hay video bạn tải lên đều được quy đổi thành token. Một tệp PDF vài trăm trang có thể chiếm hàng trăm nghìn token, lấn át cả cuộc trò chuyện.
Kết quả công cụ. Khi AI tìm kiếm web, đọc email, truy vấn tài liệu hay chạy code, kết quả trả về cũng được đưa vào cửa sổ để mô hình đọc. Một trang web dài hay một danh sách kết quả tìm kiếm đều tốn chỗ như văn bản thường.
Câu trả lời của chính AI. Đây là điểm hay bị hiểu sai nhất. Cửa sổ ngữ cảnh không chỉ chứa đầu vào, mà phải chừa chỗ cho cả phần văn bản mô hình sắp viết ra. Nếu đầu vào đã chiếm gần hết, câu trả lời có thể bị cắt ngang hoặc yêu cầu bị từ chối. Với các mô hình thuộc nhóm AI suy luận, toàn bộ chuỗi token “suy nghĩ” (thinking tokens) trước khi trả lời cũng thường được tính vào phần đầu ra này và chiếm dụng trực tiếp không gian của cửa sổ. Ngoài giới hạn tổng, mỗi mô hình còn có một mức trần riêng cho độ dài câu trả lời, thường nhỏ hơn nhiều so với cả cửa sổ.
Context window hoạt động như thế nào?
Hiểu cách cửa sổ ngữ cảnh vận hành sẽ giải thích được rất nhiều hành vi “khó hiểu” của AI, từ việc quên yêu cầu cho đến việc trả lời chậm dần khi cuộc trò chuyện kéo dài.
AI không có trí nhớ thật, mỗi lần trả lời là xử lý lại toàn bộ ngữ cảnh
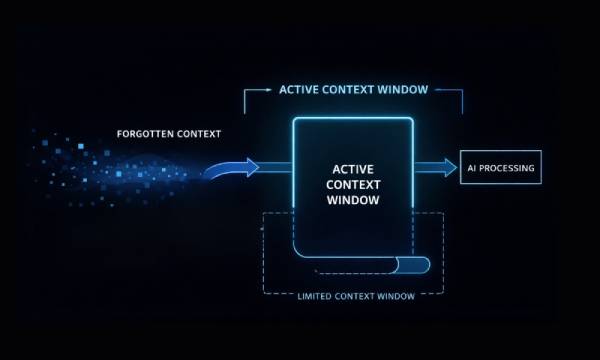
Các mô hình ngôn ngữ không “ghi nhớ” cuộc trò chuyện theo cách con người vẫn hình dung. Về bản chất, chúng không lưu trạng thái giữa các lượt. Mỗi khi bạn gửi tin nhắn mới, ứng dụng sẽ gom lời nhắc hệ thống, toàn bộ lịch sử trò chuyện, tài liệu đính kèm và tin nhắn mới thành một khối, rồi gửi cả khối đó vào mô hình. Mô hình đọc lại từ đầu đến cuối và viết câu trả lời tiếp theo, từng token một.
Cảm giác AI “nhớ” những gì bạn nói 20 tin nhắn trước thực chất là vì 20 tin nhắn đó vẫn còn nằm trong cửa sổ. Khi chúng bị đẩy ra ngoài, AI không còn cách nào biết đến chúng. Một số hệ thống dùng bộ nhớ đệm (caching) để không phải tính lại phần đã xử lý, giúp nhanh và rẻ hơn, nhưng về mặt logic, mô hình vẫn cần toàn bộ ngữ cảnh đó có mặt trong cửa sổ.
Điều gì xảy ra khi vượt giới hạn token
Khi tổng lượng token vượt quá cửa sổ, mỗi ứng dụng xử lý theo một cách khác nhau:
- Cắt bỏ phần cũ: các tin nhắn đầu tiên bị loại khỏi cửa sổ để nhường chỗ cho nội dung mới. Đây là lý do AI hay quên yêu cầu ban đầu.
- Tóm tắt tự động: một số ứng dụng nén phần hội thoại cũ thành bản tóm tắt. Cách này giữ được ý chính, nhưng chi tiết nhỏ có thể mất.
- Từ chối hoặc báo lỗi: với API, yêu cầu vượt giới hạn thường bị trả về lỗi rõ ràng. Trong ứng dụng chat, bạn có thể nhận một thông báo chung chung, hoặc cảnh báo rằng tệp tải lên quá lớn.
Chính trang hỗ trợ của Gemini cũng cảnh báo rằng khi tệp tải lên vượt quá cửa sổ ngữ cảnh, kết quả phân tích có thể không tốt, và gợi ý tải lên tệp nhỏ hơn hoặc nâng cấp lên gói có cửa sổ lớn hơn.
Vì sao cửa sổ càng lớn càng tốn chi phí và chậm hơn
Trong kiến trúc Transformer mà hầu hết mô hình hiện nay sử dụng, cơ chế “chú ý” (attention) cho phép mỗi token so sánh mối liên hệ với các token khác trong cửa sổ. Nói nôm na, khi số token tăng gấp đôi, số cặp cần so sánh có thể tăng lên khoảng gấp bốn. Các hãng đã có nhiều kỹ thuật tối ưu để giảm gánh nặng này, nhưng nguyên tắc chung vẫn đúng: ngữ cảnh càng dài thì càng cần nhiều tính toán và bộ nhớ.
Với người dùng, điều này thể hiện qua hai điểm. Thứ nhất, câu trả lời trong cuộc chat dài thường xuất hiện chậm hơn. Thứ hai, với API, bạn trả tiền cho mọi token đầu vào ở mỗi lượt, nên một cuộc chat 500.000 token tốn kém hơn rất nhiều so với một câu hỏi ngắn. Một số hãng còn áp dụng mức giá cao hơn khi yêu cầu vượt qua một ngưỡng nhất định, ví dụ Google tính giá Gemini 3.1 Pro khác nhau cho yêu cầu dưới và trên 200.000 token.
Cửa sổ ngữ cảnh lớn có luôn tốt hơn không?
Các hãng AI thường quảng bá kích thước context window như một thông số “càng lớn càng tốt”. Thực tế phức tạp hơn: cửa sổ lớn cho phép đưa vào nhiều thông tin hơn, nhưng không đảm bảo mô hình sử dụng tốt toàn bộ thông tin đó.
Hiện tượng lost-in-the-middle
Năm 2023, một nhóm nghiên cứu có sự tham gia của Đại học Stanford công bố nghiên cứu mang tên “Lost in the Middle”. Nhóm đặt một mẩu thông tin cần tìm ở nhiều vị trí khác nhau trong một ngữ cảnh dài và phát hiện một quy luật rõ ràng: mô hình tìm thấy thông tin tốt nhất khi nó nằm ở đầu hoặc cuối ngữ cảnh, và kém hơn hẳn khi nó nằm ở giữa. Đường hiệu suất có hình chữ U.
Các mô hình đời mới đã cải thiện đáng kể ở điểm này, nhưng bài học thực tế vẫn giữ nguyên giá trị: nếu một yêu cầu quan trọng bị chôn giữa hàng trăm trang tài liệu, khả năng nó bị bỏ sót sẽ cao hơn.
Context rot: ngữ cảnh quá dài làm chất lượng trả lời giảm
“Context rot” (tạm dịch: ngữ cảnh bị “mục”) là thuật ngữ chỉ hiện tượng chất lượng trả lời giảm dần khi lượng ngữ cảnh tăng lên, ngay cả khi vẫn còn xa mới chạm giới hạn cửa sổ. Nhiều thử nghiệm độc lập trong năm 2025 với hàng chục mô hình cho thấy độ chính xác thường giảm khi đầu vào dài ra, đặc biệt khi ngữ cảnh chứa nhiều thông tin gây nhiễu hoặc gần giống với thông tin cần tìm.
Trong một cuộc chat dài, “nhiễu” chính là những bản nháp cũ, những hướng đã bỏ, những yêu cầu đã được thay thế. Mô hình vẫn phải đọc tất cả, và đôi khi lại bám vào phiên bản cũ thay vì phiên bản bạn muốn. Lượng dữ liệu quá tải và mâu thuẫn này cũng là nguyên nhân phổ biến dẫn đến tình trạng AI hallucination, khiến mô hình đưa ra những câu trả lời sai lệch hoặc bịa đặt thông tin nhưng vẫn trình bày với giọng điệu rất tự tin.
Kích thước quảng cáo và kích thước hiệu quả có thể khác nhau
Con số “1 triệu token” trên trang giới thiệu là giới hạn kỹ thuật tối đa mà mô hình chấp nhận. Phạm vi mà mô hình thực sự suy luận tốt, thường được gọi là kích thước hiệu quả, có thể nhỏ hơn, và khác nhau tùy loại tác vụ. Tìm một câu cụ thể trong tài liệu dài thường dễ hơn nhiều so với tổng hợp và suy luận trên thông tin rải rác khắp cả tài liệu. Ngoài ra, một số công cụ còn chủ động đặt mức mặc định thấp hơn thông số tối đa của mô hình để cân bằng tốc độ và chi phí.
Kết luận: chọn đúng thông tin quan trọng hơn nhét thật nhiều thông tin
Cửa sổ lớn là một lợi thế thật sự, nhất là khi cần phân tích cả một kho code hay một bộ hồ sơ dài. Nhưng với phần lớn công việc hằng ngày, một ngữ cảnh gọn, sạch và đúng trọng tâm thường cho kết quả tốt hơn một ngữ cảnh khổng lồ chứa đủ thứ. Hiểu context window là gì cũng có nghĩa là hiểu rằng “đủ và đúng” quan trọng hơn “nhiều”.
So sánh context window của các mô hình AI phổ biến
Số liệu về context window thay đổi rất nhanh, và các nguồn trên mạng thường mâu thuẫn nhau. Bảng dưới đây chỉ mang tính tham khảo tại thời điểm cập nhật, con số có thể khác tùy phiên bản mô hình và gói dịch vụ, nên hãy kiểm tra tài liệu chính thức của từng hãng trước khi dựa vào đó để ra quyết định.
| Mô hình (qua API) | Hãng | Context window | Đầu ra tối đa | Ghi chú |
|---|---|---|---|---|
| Gemini 3.1 Pro | ~1 triệu token | ~64K | Giá cao hơn với yêu cầu trên 200K token | |
| Claude Opus 5.5, Sonnet 5.5, Haiku 5.5 | Anthropic | 1 triệu token | 128K | Bộ tách token mới: 1 triệu token ≈ 555.000 từ tiếng Anh |
| GPT-5.6 và các bản mới hơn | OpenAI | ~1,05 triệu token | ~128K | Theo nguồn tổng hợp; cần đối chiếu tài liệu OpenAI |
| Llama 4 Scout | Meta (mô hình mở) | 10 triệu token | Không cố định | Con số do Meta công bố khi ra mắt năm 2025 |
Xu hướng chung khá rõ: các mô hình hàng đầu của Google, Anthropic và OpenAI đều đã hội tụ quanh mức khoảng 1 triệu token qua API, trong khi một số mô hình mở công bố mức lớn hơn nhiều. Chỉ vài năm trước, 8.000 hay 32.000 token đã là con số đáng kể. Dù vậy, như phần trước đã phân tích, con số công bố không phản ánh đầy đủ khả năng dùng tốt toàn bộ ngữ cảnh.
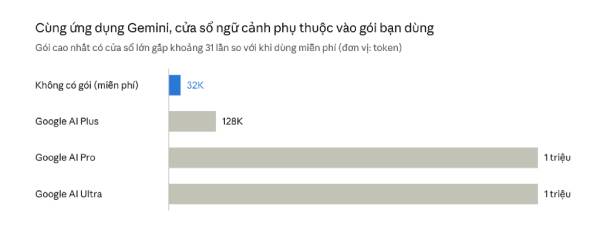
Lưu ý quan trọng: giới hạn trong ứng dụng có thể khác giới hạn API. Khi dùng chatbot qua web hay điện thoại, bạn thường không được dùng toàn bộ cửa sổ mà mô hình hỗ trợ. Gemini là ví dụ rõ nhất, vì Google công bố công khai giới hạn theo từng gói:
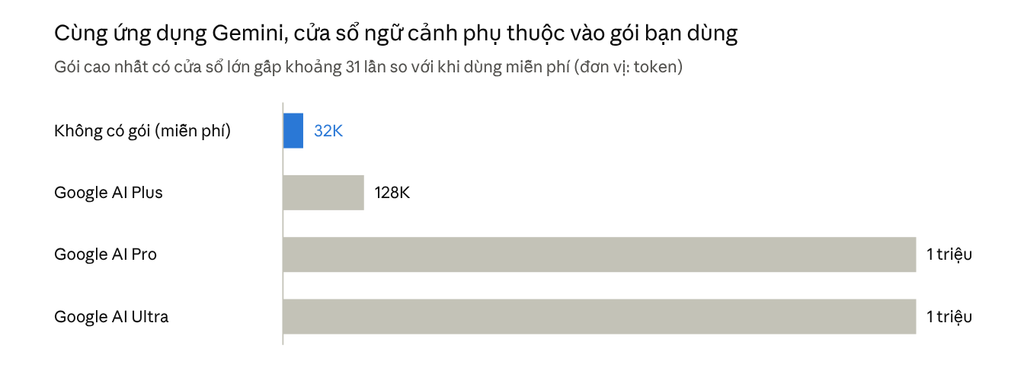
Trang hỗ trợ Gemini Apps limits của Google, tra cứu tháng 10/2026
ChatGPT cũng tương tự: cửa sổ ngữ cảnh phụ thuộc vào gói và vào việc bạn dùng chế độ trả lời nhanh hay chế độ suy luận, và thường nhỏ hơn đáng kể so với mức của API. Với người dùng miễn phí, giới hạn này có thể chỉ vào khoảng vài chục nghìn token, đủ cho trò chuyện thông thường nhưng dễ đầy khi tải tài liệu dài. Nếu công việc của bạn phụ thuộc vào ngữ cảnh lớn, hãy kiểm tra bảng giới hạn của gói bạn đang dùng, thay vì chỉ nhìn thông số của mô hình.
Context window ảnh hưởng thế nào đến trải nghiệm dùng AI hằng ngày?
Với người dùng phổ thông, giới hạn của cửa sổ ngữ cảnh hiếm khi hiện ra dưới dạng một con số. Nó thường lộ diện qua những tình huống quen thuộc dưới đây.
AI quên yêu cầu ở đầu cuộc trò chuyện dài. Bạn dặn AI viết theo giọng trang trọng, không dùng gạch đầu dòng. Sau vài chục lượt, nó bắt đầu viết suồng sã và đầy gạch đầu dòng. Nguyên nhân có thể là yêu cầu đầu tiên đã bị đẩy ra khỏi cửa sổ, hoặc vẫn còn đó nhưng bị chìm giữa một lượng lớn nội dung phía sau.
Câu trả lời lệch hoặc mâu thuẫn khi chat quá dài. Khi một cuộc trò chuyện chứa nhiều phiên bản của cùng một tài liệu, AI có thể lẫn lộn bản cũ với bản mới, lặp lại một đoạn đã bị bạn gạch bỏ, hoặc đưa ra câu trả lời trái ngược với điều nó vừa nói. Đây chính là biểu hiện thực tế của context rot.
Trả lời chậm dần, hoặc báo lỗi. Cuộc chat càng nặng, mỗi lượt trả lời càng mất nhiều thời gian xử lý. Ở trường hợp nặng hơn, bạn có thể gặp thông báo lỗi. Với Gemini, cộng đồng người dùng và tình nguyện viên trên diễn đàn hỗ trợ đã liên hệ một số mã lỗi với chat quá dài hoặc quá tải ngữ cảnh, chẳng hạn lỗi 1152 hay gặp khi dùng Canvas và chat dài, lỗi 1185 làm kẹt một cuộc trò chuyện, hay một số trường hợp của lỗi 1076 của Gemini. Cần lưu ý đây là tổng hợp từ cộng đồng, Google chưa xác nhận chính thức ý nghĩa của các mã này.
Tệp tải lên bị đọc thiếu. Khi tải một tài liệu quá dài so với cửa sổ của gói đang dùng, AI có thể chỉ đọc được một phần, trả lời dựa trên phần đầu rồi bỏ qua phần sau, hoặc cảnh báo rằng tệp quá lớn. Nếu AI khẳng định tài liệu “không đề cập” đến một nội dung mà bạn biết chắc là có, hãy nghĩ đến khả năng này đầu tiên.
7 mẹo quản lý context window hiệu quả
Quản lý cửa sổ ngữ cảnh không đòi hỏi kiến thức kỹ thuật. Bảy mẹo dưới đây áp dụng được cho Gemini, ChatGPT, Claude và hầu hết các trợ lý AI khác.
1. Chia công việc lớn thành nhiều cuộc trò chuyện ngắn
Khi nào dùng: dự án gồm nhiều phần việc độc lập, như viết một báo cáo nhiều chương hay xây dựng một ứng dụng nhiều module.
Ví dụ: một chat cho dàn ý, mỗi chương một chat riêng.
Mức hiệu quả: rất cao, vì mỗi cuộc trò chuyện luôn gọn và tập trung.
2. Tóm tắt ngữ cảnh rồi mở chat mới
Khi nào dùng: chat đã qua vài chục lượt, AI bắt đầu quên hoặc trả lời chậm.
Ví dụ: yêu cầu “Tóm tắt mục tiêu, các quyết định đã chốt và việc còn dở dang trong dưới 300 từ”, sau đó dán bản tóm tắt vào đầu một chat mới.
Mức hiệu quả: cao; bạn giữ được phần cốt lõi và loại bỏ toàn bộ “nhiễu”.
3. Đặt thông tin và yêu cầu quan trọng ở đầu hoặc cuối prompt
Khi nào dùng: prompt có kèm tài liệu dài.
Ví dụ: dán tài liệu trước, rồi đặt câu hỏi cụ thể và các yêu cầu định dạng ở cuối, thay vì kẹp chúng vào giữa. Với yêu cầu cực kỳ quan trọng, có thể nhắc lại ngắn gọn ở cả đầu lẫn cuối.
Mức hiệu quả: trung bình đến cao, giảm nguy cơ lost-in-the-middle.
4. Chỉ đưa vào phần tài liệu liên quan
Khi nào dùng: bạn chỉ cần hỏi về một phần của tài liệu lớn.
Ví dụ: thay vì tải cả báo cáo thường niên 200 trang, chỉ dán chương tài chính đang cần phân tích.
Mức hiệu quả: cao, vừa tiết kiệm cửa sổ vừa giúp câu trả lời chính xác hơn.
5. Viết prompt gọn, bỏ lặp
Khi nào dùng: luôn luôn, đặc biệt với các chỉ dẫn tùy chỉnh dùng lại nhiều lần như Gem hay hướng dẫn dự án.
Ví dụ: gộp ba câu nói cùng một ý thành một, bỏ những lời dẫn dắt không mang thông tin.
Mức hiệu quả: trung bình; mỗi lần tiết kiệm không nhiều, nhưng cộng dồn đáng kể vì chỉ dẫn được nạp lại ở mọi lượt.
6. Dùng công cụ đếm token trước khi gửi
Khi nào dùng: bạn là nhà phát triển dùng API, hoặc cần ước lượng một tài liệu có vừa cửa sổ hay không.
Ví dụ: Google, Anthropic và OpenAI đều cung cấp cách đếm token chính xác theo bộ tách token của mình, qua API hoặc công cụ trên web.
Mức hiệu quả: cao với người dùng API, giúp tránh lỗi vượt giới hạn và kiểm soát chi phí.
7. Lưu kết quả quan trọng ra ngoài
Khi nào dùng: mỗi khi có một kết quả ưng ý.
Ví dụ: sao chép đoạn văn hoặc code đã duyệt sang Google Docs hay kho mã nguồn, thay vì chỉ để trong lịch sử chat.
Mức hiệu quả: rất cao về mặt an toàn. Khi chat đầy hoặc gặp lỗi, bạn chỉ cần mang bản đã lưu sang một cuộc trò chuyện mới.
Context window, RAG và bộ nhớ dài hạn khác nhau thế nào?
Khi tìm hiểu context window là gì, bạn sẽ sớm gặp hai khái niệm liên quan là RAG và bộ nhớ dài hạn. Ba thứ này thường được dùng cùng nhau, nhưng giải quyết những bài toán khác nhau.
Context window là bộ nhớ làm việc trong một phiên: mọi thứ mô hình đang “nhìn thấy” ngay lúc này.
RAG (Retrieval-Augmented Generation, tạo sinh có truy xuất) là kỹ thuật tìm và lấy đúng những đoạn tài liệu liên quan từ một kho lớn, rồi chỉ đưa các đoạn đó vào cửa sổ. Thay vì nhét cả thư viện lên bàn, RAG giống một thủ thư mang đến đúng vài trang bạn cần. Các tính năng như hỏi đáp trên kho tài liệu nội bộ hay NotebookLM đều dựa trên ý tưởng này.
Bộ nhớ dài hạn (các tính năng ghi nhớ, cá nhân hóa, tham chiếu cuộc trò chuyện cũ) lưu lại một số thông tin giữa các phiên, như sở thích hay bối cảnh công việc của bạn. Khi cần, những thông tin này được nạp ngược lại vào cửa sổ của phiên mới. Nói cách khác, bộ nhớ dài hạn cũng phải “đi qua” context window mới được sử dụng.
| Context window | RAG | Bộ nhớ dài hạn | |
|---|---|---|---|
| Chức năng | Chứa mọi thứ mô hình xử lý trong một lần | Tìm và đưa đúng đoạn tài liệu vào cửa sổ | Lưu thông tin giữa các phiên |
| Giới hạn | Kích thước cố định theo mô hình và gói | Phụ thuộc chất lượng tìm kiếm; có thể bỏ sót đoạn cần | Chỉ lưu ý chính, không lưu nguyên văn mọi thứ |
| Khi nào dùng | Công việc trong một cuộc trò chuyện | Hỏi đáp trên kho tài liệu lớn hơn cửa sổ | Duy trì bối cảnh cá nhân qua nhiều ngày |
Context window và việc tối ưu nội dung cho AI search
Các công cụ tìm kiếm bằng AI, từ AI Overviews của Google đến các chatbot có duyệt web, tất cả đều phải đưa nội dung trang web vào context window trước khi tổng hợp câu trả lời. Vì cửa sổ có hạn và mỗi lần thường phải chứa nhiều nguồn, hệ thống có xu hướng chỉ lấy một phần nội dung của mỗi trang.
Từ góc nhìn này, một số nguyên tắc viết quen thuộc trở nên càng có ý nghĩa. Trả lời trực diện ngay đầu đoạn giúp phần quan trọng nhất có mặt trong đoạn trích được lấy. Cấu trúc rõ ràng với tiêu đề mô tả đúng nội dung giúp hệ thống xác định nhanh đoạn nào liên quan đến câu hỏi. Mỗi đoạn nên tự đứng được, không phụ thuộc vào ngữ cảnh ở một phần khác của trang vì nó có thể được trích riêng lẻ.
Cần nhấn mạnh đây chỉ là gợi ý dựa trên cách các hệ thống AI vận hành nói chung. Các công ty không công bố chi tiết cách hệ thống của họ chọn và cắt nội dung, nên không có công thức hay tỷ lệ nào đảm bảo một trang sẽ được AI trích dẫn. Viết rõ ràng, chính xác và hữu ích cho người đọc vẫn là nền tảng vững chắc nhất.
Câu hỏi thường gặp về context window
Context window là gì?
Context window (cửa sổ ngữ cảnh) là lượng văn bản tối đa mà mô hình AI có thể xem xét cùng lúc trong một lần xử lý, bao gồm lời nhắc hệ thống, lịch sử trò chuyện, tài liệu đính kèm và cả câu trả lời của chính mô hình.
Context window đo bằng gì?
Bằng token. Một token là một mẩu văn bản nhỏ, với tiếng Anh trung bình khoảng 0,75 từ. Tiếng Việt thường tốn nhiều token hơn cho cùng một lượng nội dung.
Context window càng lớn càng tốt đúng không?
Không hẳn. Cửa sổ lớn cho phép đưa vào nhiều thông tin hơn, nhưng mô hình có thể bỏ sót thông tin nằm giữa ngữ cảnh dài, và chất lượng trả lời có xu hướng giảm khi ngữ cảnh chứa nhiều nội dung gây nhiễu. Chi phí và độ trễ cũng tăng theo.
Vì sao AI quên nội dung ở đầu cuộc trò chuyện?
Có thể vì phần đầu đã bị đẩy ra khỏi cửa sổ hoặc bị tóm tắt, hoặc vì nó vẫn còn nhưng bị chìm giữa lượng lớn nội dung phía sau. Tóm tắt rồi mở chat mới là cách khắc phục hiệu quả nhất.
Context window có phải là bộ nhớ của AI không?
Chỉ là bộ nhớ làm việc ngắn hạn trong một phiên. Nó khác với kiến thức mô hình học lúc huấn luyện, và khác với các tính năng ghi nhớ lưu thông tin giữa các phiên.
Mô hình nào có context window lớn nhất?
Tại thời điểm cập nhật, các mô hình hàng đầu của Google, Anthropic và OpenAI đều ở mức khoảng 1 triệu token qua API, còn một số mô hình mở như Llama 4 Scout công bố đến 10 triệu token. Nếu muốn tự trải nghiệm các mô hình mở này ngay trên máy tính mà vẫn chủ động kiểm soát dung lượng bộ nhớ, bạn có thể tham khảo Ollama – công cụ hỗ trợ chạy mô hình ngôn ngữ lớn cục bộ linh hoạt nhất hiện nay.
Làm sao biết chat của mình sắp đầy context window?
Ứng dụng chat hiếm khi hiển thị con số này. Các dấu hiệu thường gặp gồm AI quên yêu cầu cũ, trả lời chậm dần, lẫn lộn các phiên bản, cảnh báo tệp quá lớn hoặc báo lỗi. Với API, bạn có thể dùng công cụ đếm token hoặc xem số token trả về trong mỗi phản hồi.
Kết luận
Hiểu context window là gì giúp bạn dùng AI chủ động hơn rất nhiều. Context window là bộ nhớ làm việc có giới hạn, chứa cả đầu vào lẫn câu trả lời. Cửa sổ lớn hơn không phải lúc nào cũng cho kết quả tốt hơn, vì điều quan trọng là ngữ cảnh có đủ và đúng hay không. Và quản lý ngữ cảnh, từ chia nhỏ cuộc trò chuyện đến tóm tắt rồi mở chat mới là một kỹ năng thực sự khi làm việc với AI. Để đọc thêm các bài kiến thức và tin tức AI mới nhất, hãy theo dõi Orbitaltech.