Bạn nhờ AI tìm một bài nghiên cứu để trích dẫn và nhận về tên tác giả, tên tạp chí, cả năm xuất bản rất chỉn chu, nhưng khi tra cứu thì bài báo ấy chưa từng tồn tại. Đó là ví dụ điển hình để trả lời câu hỏi AI hallucination là gì: hiện tượng AI tạo ra thông tin sai, bịa hoặc không có căn cứ, nhưng trình bày rất tự tin và hợp lý. Bài viết giải thích vì sao ảo giác AI xảy ra, các dạng thường gặp, cách nhận biết và những cách kiểm chứng thực tế, với một thông điệp xuyên suốt: AI có thể sai, và bạn cần biết cách kiểm tra.
AI hallucination là gì?
Để hiểu đúng AI hallucination là gì, cần tách bạch nó với những lỗi thông thường. Một phần mềm bị lỗi thường sẽ treo, báo lỗi hoặc cho ra kết quả rõ ràng là vô lý. AI hallucination thì ngược lại: câu trả lời trôi chảy, đúng ngữ pháp, đúng giọng chuyên gia, chỉ có nội dung là sai. Chính sự thuyết phục đó khiến hiện tượng này nguy hiểm hơn một thông báo lỗi.
Định nghĩa đơn giản
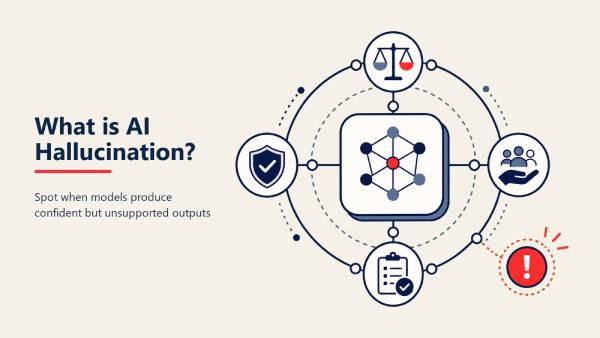
AI hallucination (ảo giác AI) là khi một mô hình AI tạo ra nội dung nghe có vẻ hợp lý nhưng sai sự thật, bịa đặt hoàn toàn, hoặc không có căn cứ trong dữ liệu được cung cấp. Ví dụ phổ biến gồm trích dẫn một bài báo không tồn tại, đưa ra số liệu không có nguồn, gán một câu nói cho người chưa từng nói, hay mô tả một tính năng phần mềm không hề có.
Trong một nghiên cứu công bố năm 2025, các nhà nghiên cứu của OpenAI định nghĩa hallucination là những phát biểu nghe hợp lý nhưng sai do mô hình tạo ra. Họ minh họa bằng một thí nghiệm đơn giản. Khi được hỏi về tiêu đề luận án tiến sĩ hay ngày sinh của chính một tác giả trong nhóm, nhiều chatbot phổ biến đưa ra các câu trả lời khác nhau, và tất cả đều sai.
Vì sao gọi là “ảo giác” và tranh luận về thuật ngữ
Từ “ảo giác” mượn từ tâm lý học, nơi nó chỉ việc cảm nhận điều không có thật. Cách gọi này dễ nhớ, nhưng không phải ai cũng đồng tình. Một số nhà nghiên cứu cho rằng nó nhân hóa AI một cách không cần thiết, như thể mô hình có nhận thức và “nhìn nhầm”. Thay vào đó, họ đề xuất những từ khác như “AI misinformation” (thông tin sai do AI tạo ra) hay “confabulation” (chứng bịa chuyện, mượn từ y học, chỉ việc người bệnh vô thức lấp khoảng trống ký ức bằng chi tiết bịa đặt mà vẫn tin là thật).
Nhiều người thấy “confabulation” mô tả chính xác hơn: AI không “thấy” gì cả, nó đang lấp đầy chỗ trống bằng thứ nghe hợp lý. Dù vậy, “hallucination” vẫn là thuật ngữ phổ biến nhất trong cả giới nghiên cứu lẫn truyền thông, nên bài viết này vẫn dùng nó.
Hallucination trong AI không chỉ ở văn bản
Ít ai biết thuật ngữ này xuất hiện trong thị giác máy tính từ trước khi chatbot ra đời. Khoảng năm 2000, cụm “face hallucination” được dùng cho các kỹ thuật tăng độ phân giải ảnh khuôn mặt, trong đó thuật toán “tưởng tượng” ra chi tiết không có trong ảnh gốc. Khi đó, “bịa” chi tiết lại là mục tiêu.
Ngày nay, hallucination trong AI xuất hiện ở nhiều dạng: mô hình tạo ảnh vẽ bàn tay sáu ngón hay chữ vô nghĩa trên biển hiệu, video AI tạo chuyển động phi vật lý, hệ thống nhận dạng hình ảnh mô tả vật thể không có trong khung hình, hay công cụ chuyển giọng nói thành văn bản tự thêm vào những câu không ai nói. Bài viết này tập trung vào văn bản, vì đây là dạng người dùng gặp nhiều nhất.
Các loại AI hallucination thường gặp
Không phải mọi trường hợp AI bịa thông tin đều giống nhau. Phân biệt được từng dạng sẽ giúp bạn biết cần kiểm tra điểm nào trong một câu trả lời.
Sai sự thật
Đây là dạng phổ biến nhất: AI nhầm ngày tháng, nhầm người, nhầm số liệu hoặc gộp chi tiết của hai sự kiện khác nhau thành một. Thông tin càng hiếm, càng cụ thể, như ngày sinh của một người ít nổi tiếng hay doanh thu của một công ty nhỏ, thì nguy cơ sai càng cao. Sai sự thật cũng hay xảy ra với sự kiện mới, khi AI trả lời dựa trên dữ liệu huấn luyện đã cũ mà không tra cứu.
Bịa nguồn và trích dẫn
AI tạo ra tên bài báo, sách, đường dẫn, số hiệu văn bản pháp luật hay bản án trông hoàn toàn thật nhưng không tồn tại. Dạng này đặc biệt nguy hiểm vì trích dẫn vốn là thứ người đọc dùng để kiểm chứng, nên một trích dẫn giả khiến câu trả lời sai trông càng đáng tin. Đôi khi tác giả có thật, tạp chí có thật, chỉ có bài báo là không.
Không trung thực với tài liệu nguồn
Ngay cả khi bạn cung cấp tài liệu, AI vẫn có thể tóm tắt thêm những ý không có trong đó, đảo ngược kết luận, hoặc trả lời câu hỏi bằng kiến thức chung thay vì nội dung tài liệu. Giới nghiên cứu gọi đây là lỗi “faithfulness”. Dạng này hay xuất hiện khi tài liệu quá dài hoặc khi yêu cầu tóm tắt quá ngắn so với lượng thông tin.
Sai logic hoặc tự mâu thuẫn
AI đưa ra một con số ở đoạn đầu rồi một con số khác ở đoạn sau, hoặc trình bày các bước lập luận có vẻ chặt chẽ nhưng kết luận không suy ra từ đó. Dạng này thường gặp trong bài toán nhiều bước, so sánh nhiều lựa chọn hay câu trả lời rất dài.
| Loại | Ví dụ minh họa | Dấu hiệu nhận biết |
|---|---|---|
| Sai sự thật | Hỏi năm thành lập một công ty khởi nghiệp nhỏ, AI đưa ra một năm cụ thể nhưng sai | Thông tin hiếm, không kèm nguồn; hỏi lại ra con số khác |
| Bịa nguồn | AI dẫn một nghiên cứu với tên tác giả và tạp chí, nhưng tra Google Scholar không thấy | Đường dẫn lỗi 404, tiêu đề không tra được |
| Không trung thực với tài liệu | Nhờ tóm tắt hợp đồng, AI thêm điều khoản phạt không có trong văn bản | Không chỉ ra được đoạn nguồn tương ứng |
| Sai logic, tự mâu thuẫn | So sánh hai gói cước, đoạn đầu nói gói A rẻ hơn, đoạn cuối khuyên chọn gói B vì rẻ hơn | Các phần trong cùng câu trả lời không khớp nhau |
Các ví dụ trên được dựng để minh họa, không phải trích từ một câu trả lời cụ thể của một mô hình.
Vì sao AI bịa thông tin mà vẫn tự tin?
Đây là câu hỏi quan trọng nhất khi tìm hiểu AI hallucination là gì. Câu trả lời không nằm ở một nguyên nhân duy nhất, mà ở cách các mô hình ngôn ngữ được xây dựng, huấn luyện và sử dụng.
AI dự đoán từ tiếp theo chứ không “biết sự thật”
Về cốt lõi, một mô hình ngôn ngữ lớn được huấn luyện để làm một việc: đoán mẩu văn bản (token) tiếp theo hợp lý nhất dựa trên những gì đã có. Nó học điều này từ hàng nghìn tỷ từ trên internet, sách và tài liệu. Kết quả là mô hình rất giỏi trong việc tạo ra văn bản “nghe đúng”, vì nó đã thấy hàng triệu văn bản tương tự.
Vấn đề là “nghe đúng” và “đúng” không phải là một. Khi được hỏi về một bài nghiên cứu, mô hình biết rất rõ một trích dẫn khoa học trông như thế nào: tên tác giả, năm, tạp chí, số trang. Nếu không nhớ chính xác một bài cụ thể, nó vẫn có thể lắp ghép ra một trích dẫn hoàn chỉnh về hình thức. Mô hình không có một “cơ sở dữ liệu sự thật” để đối chiếu trước khi nói.
Dữ liệu huấn luyện thiếu, cũ hoặc có thiên lệch
Mô hình chỉ biết những gì có trong dữ liệu huấn luyện, và dữ liệu đó dừng lại ở một mốc thời gian. Sự kiện xảy ra sau mốc đó nằm ngoài hiểu biết của nó. Thông tin hiếm, chỉ xuất hiện một hai lần trên internet, cũng rất khó để mô hình ghi nhớ chính xác. Nghiên cứu của OpenAI năm 2025 nhấn mạnh điểm này: những sự thật “tùy ý” như ngày sinh của một cá nhân không tuân theo quy luật nào để mô hình suy ra, nên nếu không nhớ, nó chỉ có thể đoán. Ngoài ra, dữ liệu chứa thông tin sai hoặc thiên lệch cũng có thể được mô hình lặp lại.
Cách huấn luyện và chấm điểm khiến mô hình “đoán thay vì nói không biết”
Đây là phần giải thích vì sao AI sai mà vẫn tự tin. Trong nghiên cứu “Why Language Models Hallucinate” công bố tháng 9/2025, nhóm tác giả của OpenAI so sánh mô hình ngôn ngữ với một học sinh đi thi trắc nghiệm. Nếu đề thi không trừ điểm khi làm sai, việc đoán bừa luôn có lợi hơn để trống, nghĩa là đoán còn có cơ hội đúng, để trống chắc chắn được không điểm.
Theo nhóm nghiên cứu, phần lớn các bài kiểm tra đánh giá mô hình AI phổ biến đang chấm điểm đúng kiểu đó: câu trả lời đúng được một điểm, còn trả lời sai và nói “tôi không biết” đều bị không điểm như nhau. Khi các mô hình được tối ưu để đứng đầu những bảng xếp hạng này, chúng được “dạy” rằng đoán tự tin luôn tốt hơn thừa nhận không chắc. Giải pháp nhóm đề xuất là thay đổi cách chấm: phạt lỗi sai tự tin nặng hơn, và ghi nhận việc thừa nhận không chắc chắn đúng lúc.
Một góc nhìn bổ sung đến từ nghiên cứu diễn giải mô hình của Anthropic năm 2025. Khi “soi” vào bên trong một mô hình Claude, các nhà nghiên cứu thấy mô hình có xu hướng mặc định là từ chối trả lời khi gặp cái tên lạ. Xu hướng này bị “tắt” khi mô hình nhận ra một đối tượng quen thuộc. Hallucination có thể xảy ra khi cơ chế này nhận nhầm: một cái tên nghe quen khiến mô hình tưởng mình biết, trong khi thực ra nó không có thông tin.
Thiết lập giải mã như temperature cao làm tăng nguy cơ
Khi tạo văn bản, mô hình chọn token tiếp theo từ nhiều khả năng với xác suất khác nhau. Thông số temperature điều chỉnh mức “ngẫu hứng” của lựa chọn này. Temperature thấp khiến mô hình bám vào lựa chọn an toàn nhất, temperature cao khiến nó sẵn sàng chọn những từ ít khả năng hơn, tốt cho sáng tạo nhưng làm tăng nguy cơ đi chệch khỏi sự thật. Người dùng ứng dụng chat thường không chỉnh được thông số này, nhưng nhà phát triển dùng API thì có thể. Nếu muốn tự kiểm soát toàn diện các thông số này trên máy tính cá nhân để giảm ảo giác, bạn có thể tìm hiểu ollama là gì – công cụ hỗ trợ chạy và tùy biến mô hình ngôn ngữ mã nguồn mở cục bộ rất phổ biến hiện nay.
Prompt mơ hồ hoặc chứa giả định sai
Cách đặt câu hỏi ảnh hưởng lớn đến kết quả. Một câu hỏi mơ hồ buộc mô hình tự đoán ý bạn. Nguy hiểm hơn là câu hỏi chứa sẵn giả định sai, chẳng hạn “Vì sao nghiên cứu X của Đại học Y kết luận Z?” trong khi nghiên cứu đó không tồn tại. Do được huấn luyện để hữu ích, mô hình có xu hướng “chiều theo” giả định và giải thích cặn kẽ cho một điều không có thật.
Ngữ cảnh quá dài hoặc quá tải
Khi cuộc trò chuyện quá dài hay tài liệu quá lớn, mô hình có thể bỏ sót thông tin nằm giữa ngữ cảnh, nhầm lẫn giữa phiên bản cũ và mới, hoặc quên yêu cầu ban đầu. Khi đó, nó dễ lấp chỗ trống bằng thông tin tự đoán. Bạn có thể đọc thêm về cơ chế này trong bài context window là gì và vì sao AI hay quên.
Tổng hợp lại, nhiều nhà nghiên cứu cho rằng hallucination là một đặc điểm mang tính cấu trúc của mô hình ngôn ngữ, chứ không đơn thuần là một lỗi sẽ tự biến mất khi mô hình lớn hơn. Các mô hình mới đã giảm đáng kể tần suất, nhưng không hãng nào tuyên bố đã loại bỏ hoàn toàn.
Ảo giác AI có hoàn toàn xấu không?
Nghe có vẻ ngược đời, nhưng một số nghiên cứu học thuật lập luận rằng khả năng “bịa” không hoàn toàn là khuyết điểm. Cùng một cơ chế khiến AI tạo ra trích dẫn giả cũng là cơ chế giúp nó viết một truyện ngắn mới, đặt tên cho một sản phẩm chưa có hay gợi ý một hướng giải quyết chưa ai nghĩ đến. Một mô hình chỉ biết lặp lại đúng nguyên văn những gì đã học sẽ an toàn hơn nhưng cũng kém linh hoạt và kém hữu ích đi rất nhiều.
Từ góc nhìn này, vấn đề không nằm ở việc AI có khả năng tạo ra nội dung mới mà ở việc nó làm điều đó sai lúc. Sáng tạo là điểm mạnh khi bạn cần viết truyện, lên ý tưởng quảng cáo, đặt tiêu đề, hay brainstorm tính năng sản phẩm. Nhưng cũng khả năng ấy lại trở thành rủi ro khi bạn cần sự thật: tra cứu luật, tính toán tài chính, tìm thông tin sức khỏe hay trích dẫn nguồn.
Thay vì kỳ vọng một AI không bao giờ bịa, cách tiếp cận thực tế hơn là tự xác định rõ từng tác vụ cần “sáng tạo” hay cần “chính xác”, rồi điều chỉnh cách dùng và mức độ kiểm chứng cho phù hợp. Với câu hỏi đòi hỏi sự thật, hãy bật tính năng tìm kiếm, yêu cầu nguồn và luôn kiểm tra lại. Với công việc sáng tạo, bạn có thể thoải mái hơn.
Tác động của AI hallucination
Mức độ nghiêm trọng của một lần AI bịa thông tin phụ thuộc hoàn toàn vào việc thông tin đó được dùng vào đâu. Một gợi ý sai về công thức nấu ăn và một trích dẫn luật sai là hai câu chuyện rất khác nhau.
Với người dùng cá nhân
Rủi ro rõ nhất là ra quyết định dựa trên thông tin sai: chọn mua sản phẩm vì một tính năng không tồn tại, lên kế hoạch du lịch theo giờ mở cửa sai hay nộp hồ sơ theo một quy định đã hết hiệu lực. Với học sinh, sinh viên, rủi ro còn là học sai kiến thức hoặc nộp bài có trích dẫn giả và bị xử lý về liêm chính học thuật.
Với doanh nghiệp và nội dung
Với doanh nghiệp, AI hallucination có thể gây mất uy tín và cả rủi ro pháp lý. Ví dụ được nhắc đến nhiều là vụ Moffatt kiện Air Canada tại Canada: năm 2024, một hội đồng giải quyết tranh chấp của tỉnh British Columbia buộc hãng hàng không bồi thường cho một hành khách, sau khi chatbot trên website của hãng mô tả sai chính sách giảm giá vé cho trường hợp có người thân qua đời. Hội đồng bác bỏ lập luận rằng chatbot phải tự chịu trách nhiệm và cho rằng doanh nghiệp phải chịu trách nhiệm về thông tin trên website của mình.
Với những đơn vị sản xuất nội dung, một bài viết chứa số liệu bịa hay trích dẫn giả có thể làm tổn hại uy tín được xây dựng trong nhiều năm, chưa kể nguy cơ vi phạm bản quyền hay phỉ báng nếu AI gán thông tin sai cho một cá nhân có thật.
Với lĩnh vực nhạy cảm như y tế, tài chính, pháp lý
Đây là nơi hậu quả có thể nghiêm trọng nhất. Trong lĩnh vực pháp lý, vụ Mata kiện Avianca tại New York năm 2023 trở thành bài học kinh điển: hai luật sư nộp lên tòa một bản lập luận trích dẫn nhiều bản án do ChatGPT tạo ra, và các bản án này không hề tồn tại. Thẩm phán sau đó đã phạt tiền hai luật sư và công ty của họ. Kể từ đó, nhiều vụ việc tương tự tiếp tục được ghi nhận tại tòa án ở nhiều quốc gia.
Trong y tế, các tổng quan hệ thống về ứng dụng AI cho thấy hallucination là một trong những rào cản lớn nhất khi đưa mô hình ngôn ngữ vào môi trường lâm sàng. Một liều lượng sai, một tương tác thuốc bị bỏ sót hay một lời khuyên tài chính dựa trên số liệu bịa đều có thể gây thiệt hại thật. Với các lĩnh vực này, AI chỉ nên đóng vai trò hỗ trợ tìm hiểu ban đầu. Quyết định cuối cùng cần có chuyên gia như bác sĩ, luật sư hay cố vấn tài chính.
Cách nhận biết AI bịa thông tin
Không có dấu hiệu nào chắc chắn 100% vì điểm nguy hiểm nhất của hallucination là nó trông giống hệt một câu trả lời đúng. Dù vậy, có một số tín hiệu nên khiến bạn chậm lại và kiểm tra.
Giọng điệu quá chắc chắn với câu hỏi khó. Nếu bạn hỏi một điều rất hiếm, rất mới hoặc còn tranh cãi nhưng AI trả lời dứt khoát không một chút do dự, đó là lúc nên nghi ngờ.
Số liệu quá cụ thể mà không có nguồn. Những con số như “73,4% doanh nghiệp” hay “tăng 2,7 lần” tạo cảm giác chính xác nhưng nếu không đi kèm nguồn kiểm chứng được, chúng có thể hoàn toàn bịa đặt.
Đường dẫn, tên tác giả hoặc tài liệu lạ. Đường dẫn trả về lỗi 404, tên bài báo không tra được trên Google Scholar hay số hiệu văn bản không có trên cổng thông tin chính thức đều là cờ đỏ rõ ràng.
Câu trả lời thay đổi khi hỏi lại. Một sự thật thật sự thường ổn định. Nếu hỏi lại cùng một câu hoặc mở chat mới mà AI đưa ra ngày tháng, con số hay tên người khác nhau, khả năng cao là nó đang đoán.
AI dễ dàng “đồng ý” với mọi phản bác. Nếu bạn nói “Tôi nghĩ con số đó sai” và AI lập tức xin lỗi rồi đưa ra một con số mới cũng chắc chắn không kém, rất có thể cả hai con số đều không có căn cứ.
Mẹo kiểm tra nhanh: hỏi lại “Nguồn của thông tin này là gì?”; đặt cùng câu hỏi bằng cách diễn đạt khác. Ví dụ hỏi ngược lại chi tiết (“Trang nào trong tài liệu nói điều này?”). Và quan trọng nhất, tự tra cứu độc lập bằng công cụ tìm kiếm hoặc nguồn chính thức.
➧ Danh sách 5 cờ đỏ cần kiểm tra:
- Câu trả lời có số liệu, ngày tháng hoặc tên riêng mà bạn sẽ dùng để ra quyết định.
- Có trích dẫn, đường dẫn hoặc tên tài liệu chưa được bạn mở ra kiểm tra.
- Chủ đề hiếm, mới xảy ra hoặc nằm ngoài kiến thức phổ thông.
- Hỏi lại thì nhận được câu trả lời khác.
- Thông tin thuộc lĩnh vực y tế, pháp lý hoặc tài chính.
Chỉ cần dính một lỗi kể trên, bạn đã nên kiểm chứng trước khi sử dụng thông tin.
7 cách hạn chế và kiểm chứng AI hallucination
Trước khi bắt đầu, cần nói rõ: không cách nào dưới đây loại bỏ hoàn toàn AI hallucination. Chúng giúp giảm tần suất và giúp bạn phát hiện lỗi sớm hơn. Hiệu quả nhất là kết hợp nhiều lớp cùng lúc.
1. Viết prompt rõ ràng, cung cấp ngữ cảnh và tài liệu nguồn
Khi nào dùng: khi câu trả lời cần dựa trên thông tin cụ thể, như hợp đồng, báo cáo hay tài liệu nội bộ.
Prompt mẫu: “Dựa hoàn toàn vào tài liệu tôi dán bên dưới, hãy liệt kê các điều khoản về thời hạn thanh toán. Nếu tài liệu không đề cập, hãy nói rõ là không có, đừng suy đoán.”
Giới hạn: AI vẫn có thể diễn giải sai hoặc bỏ sót, nhất là với tài liệu rất dài.
2. Yêu cầu AI nêu nguồn và thừa nhận khi không chắc chắn
Khi nào dùng: với mọi câu hỏi về sự thật, số liệu hay sự kiện.
Prompt mẫu: “Trả lời câu hỏi sau. Với mỗi thông tin quan trọng, hãy nêu nguồn cụ thể. Nếu bạn không chắc chắn ở điểm nào, hãy nói rõ mức độ chắc chắn thay vì đoán. Tôi thà nhận câu ‘tôi không biết’ còn hơn một câu trả lời sai.”
Giới hạn: nếu không có công cụ tìm kiếm, chính nguồn được nêu cũng có thể bị bịa. Luôn mở ra kiểm tra.
3. Chia câu hỏi phức tạp thành các bước nhỏ
Khi nào dùng: bài toán nhiều bước, phân tích so sánh hay câu hỏi gồm nhiều phần.
Prompt mẫu: “Trước tiên, hãy liệt kê các thông số của hai sản phẩm từ tài liệu. Sau khi tôi xác nhận, hãy so sánh từng thông số. Cuối cùng mới đưa ra khuyến nghị.”
Giới hạn: mất thời gian hơn nhưng giúp bạn bắt lỗi ngay ở bước nó xuất hiện thay vì phát hiện khi đã quá muộn.
4. Hỏi lại hoặc dùng nhiều công cụ để đối chiếu
Khi nào dùng: thông tin quan trọng mà bạn không tự kiểm tra được ngay.
Prompt mẫu: “Hãy xem lại câu trả lời trước của bạn. Liệt kê những phát biểu nào bạn chắc chắn, phát biểu nào có thể sai và vì sao.” Sau đó, đặt cùng câu hỏi cho một chatbot khác (Gemini, ChatGPT, Claude…) và so sánh.
Giới hạn: nhiều mô hình có thể cùng sai theo một cách, vì chúng học từ những nguồn dữ liệu tương tự. Đồng thuận giữa các AI không thay thế được nguồn độc lập.
5. Kiểm chứng thông tin quan trọng với nguồn đáng tin cậy
Khi nào dùng: bất cứ khi nào thông tin sẽ được xuất bản, nộp đi hoặc dùng để ra quyết định.
Cách làm: với luật, tra trên cổng thông tin văn bản pháp luật chính thức; với nghiên cứu, tra trên Google Scholar hoặc trang của tạp chí; với số liệu doanh nghiệp, xem báo cáo tài chính gốc; với sức khỏe, hỏi bác sĩ hoặc tham khảo tổ chức y tế uy tín.
Giới hạn: tốn thời gian, nhưng đây là lớp bảo vệ đáng tin cậy nhất.
6. Dùng tính năng tìm kiếm hoặc RAG khi cần thông tin cập nhật
Khi nào dùng: câu hỏi về tin tức, giá cả, sản phẩm mới, chính sách hiện hành hay bất cứ điều gì có thể đã thay đổi.
Prompt mẫu: “Hãy tìm kiếm trên web và trả lời dựa trên các nguồn mới nhất. Ghi rõ ngày đăng và đường dẫn của từng nguồn.”
Giới hạn: AI vẫn có thể đọc sai hoặc tóm tắt lệch kết quả tìm kiếm, và bản thân nguồn trên web cũng có thể sai. Hãy mở các đường dẫn quan trọng ra đọc trực tiếp.
7. Giữ con người trong vòng kiểm soát với nội dung quan trọng
Khi nào dùng: nội dung xuất bản, tài liệu pháp lý, báo cáo gửi khách hàng, quyết định tài chính hay y tế.
Cách làm: xem AI như một trợ lý soạn nháp nhanh, không phải người duyệt cuối. Mọi số liệu, trích dẫn và kết luận phải được một người có chuyên môn kiểm tra trước khi sử dụng. Người ký tên cuối cùng luôn là người chịu trách nhiệm, như vụ việc của các luật sư ở New York đã cho thấy.
Giới hạn: con người cũng có thể bỏ sót, nhất là khi tin AI quá mức và chỉ lướt qua. Kiểm tra có chủ đích (theo danh sách cờ đỏ đã được đề cập ở phần trên phần trước) sẽ hiệu quả hơn đọc lướt.
Doanh nghiệp giảm hallucination trong AI như thế nào?
Với doanh nghiệp triển khai AI cho khách hàng hoặc nội bộ, câu hỏi không chỉ là AI hallucination là gì, mà là làm sao giảm rủi ro ở quy mô lớn. Các cách tiếp cận phổ biến hiện nay đều theo nguyên tắc nhiều lớp bảo vệ.
RAG (tạo sinh có truy xuất). Thay vì để mô hình trả lời từ trí nhớ, hệ thống tìm đoạn tài liệu liên quan trong kho dữ liệu đã kiểm duyệt, như chính sách, sổ tay sản phẩm hay câu hỏi thường gặp, rồi yêu cầu mô hình trả lời dựa trên đó và dẫn nguồn. RAG giảm đáng kể việc AI bịa thông tin về doanh nghiệp, nhưng chất lượng phụ thuộc vào chất lượng tài liệu và khâu tìm kiếm.
Cho phép mô hình từ chối. Chỉ dẫn hệ thống nên nói rõ rằng khi không tìm thấy câu trả lời trong tài liệu, chatbot phải nói “tôi không có thông tin” và chuyển cho nhân viên thay vì cố trả lời. Đây cũng là tinh thần của đề xuất trong nghiên cứu của OpenAI: thưởng cho sự thận trọng thay vì phạt nó.
Kiểm tra sau khi sinh nội dung. Một số hệ thống dùng bước kiểm tra tự động, chẳng hạn đối chiếu từng phát biểu trong câu trả lời với tài liệu nguồn hoặc dùng một mô hình khác để đánh dấu nội dung không có căn cứ trước khi gửi đến người dùng.
Đánh giá định kỳ. Xây dựng bộ câu hỏi kiểm tra riêng cho từng ứng dụng, bao gồm cả những câu hỏi “bẫy” mà câu trả lời đúng là không biết, rồi chạy lại mỗi khi đổi mô hình hay cập nhật tài liệu.
Chính sách sử dụng AI nội bộ. Quy định rõ loại công việc nào được dùng AI, nội dung nào bắt buộc có người duyệt và ai chịu trách nhiệm cuối cùng. Vụ Air Canada cho thấy doanh nghiệp không thể đổ lỗi cho chatbot của chính mình.
Câu hỏi thường gặp về AI hallucination
1. AI hallucination là gì?
AI hallucination (ảo giác AI) là hiện tượng mô hình AI tạo ra thông tin sai, bịa hoặc không có căn cứ, nhưng trình bày một cách trôi chảy và tự tin như thể đó là sự thật. Ví dụ phổ biến là trích dẫn tài liệu không tồn tại hoặc đưa ra số liệu bịa.
2. Vì sao ChatGPT, Gemini và các chatbot khác hay bịa thông tin?
Vì các mô hình ngôn ngữ được huấn luyện để tạo ra văn bản hợp lý nhất, không phải để kiểm chứng sự thật. Theo nghiên cứu của OpenAI năm 2025, cách huấn luyện và chấm điểm hiện nay còn thưởng cho việc đoán hơn là thừa nhận không biết. Dữ liệu cũ, thông tin hiếm và prompt mơ hồ cũng góp phần.
3. AI hallucination có thể biến mất hoàn toàn không?
Theo nhiều nhà nghiên cứu, khó có khả năng đó với kiến trúc hiện tại. Các biện pháp như RAG, tìm kiếm web và huấn luyện mô hình biết từ chối giúp giảm tần suất đáng kể nhưng chưa thể đưa về con số không.
4. Mô hình mới có còn bị hallucination không?
Có. Các mô hình đời mới thường ít bịa hơn, nhất là khi tìm hiểu sâu về bản chất ai suy luận là gì (reasoning models) với chuỗi tư duy từng bước hoặc có tích hợp tìm kiếm, nhưng không mô hình nào miễn nhiễm. Tỷ lệ cụ thể thay đổi theo từng bài kiểm tra và từng loại câu hỏi, nên hãy thận trọng với các con số so sánh lan truyền trên mạng.
5. Làm sao biết AI đang nói sai?
Hãy chú ý các cờ đỏ: số liệu quá cụ thể mà không có nguồn, đường dẫn không mở được, câu trả lời thay đổi khi hỏi lại. Cách chắc chắn nhất vẫn là tự tra cứu với nguồn độc lập, đáng tin cậy.
6. AI hallucination khác lỗi thông thường của phần mềm thế nào?
Lỗi phần mềm thường do sai sót trong mã nguồn, có thể tìm ra và sửa dứt điểm, và hay biểu hiện rõ ràng như treo máy hay báo lỗi. Hallucination lại xuất phát từ bản chất xác suất của mô hình, không có một dòng mã nào để sửa và trông giống hệt một câu trả lời đúng.
7. Có nên dùng AI cho thông tin y tế, pháp lý, tài chính không?
Có thể dùng để tìm hiểu ban đầu, giải thích thuật ngữ hay chuẩn bị câu hỏi trước khi gặp chuyên gia. Nhưng không nên dựa vào AI để ra quyết định về điều trị, thủ tục pháp lý hay đầu tư. Những việc này cần bác sĩ, luật sư hoặc cố vấn tài chính có chuyên môn.
Kết luận
Hiểu AI hallucination là gì là bước đầu tiên để dùng AI một cách an toàn. Ảo giác AI không phải một lỗi hiếm gặp sẽ sớm biến mất mà là đặc điểm mang tính cấu trúc của mô hình ngôn ngữ, bắt nguồn từ cách chúng được xây dựng và chấm điểm. Vì vậy, kỹ năng quan trọng nhất là biết nhận ra cờ đỏ và kiểm chứng thông tin quan trọng bằng nguồn độc lập. Với mọi quyết định có hậu quả thật, con người vẫn phải là người nói lời cuối. Theo dõi Orbitaltech để cập nhật thêm các kiến thức cũng như hiểu hơn về các trợ lý AI nhé.