Bạn muốn dùng AI cho tài liệu công việc nhưng ngại gửi dữ liệu lên máy chủ của bên thứ ba, không muốn trả phí theo lượt, hoặc cần một trợ lý vẫn chạy khi mất mạng? Đó là lúc câu hỏi Ollama là gì trở nên đáng quan tâm. Nói ngắn gọn, Ollama là công cụ mã nguồn mở giúp tải và chạy mô hình ngôn ngữ lớn (LLM) ngay trên máy tính của bạn. Bài viết giải thích cách Ollama hoạt động, cấu hình cần có theo từng cỡ mô hình, cách cài đặt, Ollama Cloud, lưu ý bảo mật và khi nào nên chọn Ollama thay vì ChatGPT hay Gemini.
Ollama là gì?
Phần lớn người dùng tiếp cận AI qua các dịch vụ trên mây như ChatGPT, Gemini hay Claude: bạn gõ câu hỏi, câu hỏi được gửi lên máy chủ của nhà cung cấp, câu trả lời được gửi về. Ollama đảo ngược mô hình đó: mô hình AI nằm ngay trên ổ cứng của bạn, và mọi việc xử lý diễn ra trên chính chiếc máy bạn đang dùng.
Định nghĩa đơn giản
Ollama là một trình quản lý và máy chủ chạy mô hình AI cục bộ. Nó đảm nhận ba việc: tải mô hình về máy, nạp mô hình vào bộ nhớ để chạy, và cung cấp một giao diện lập trình (API) để bạn hoặc các ứng dụng khác gửi câu hỏi vào. Bạn có thể dùng Ollama qua dòng lệnh, qua ứng dụng desktop có giao diện chat, hoặc tích hợp vào phần mềm của riêng mình.
Trước khi có những công cụ như Ollama, việc chạy LLM trên máy tính cá nhân đòi hỏi cài đặt thư viện, biên dịch mã nguồn, tự tìm và chuyển đổi tệp mô hình. Ollama gói gọn toàn bộ quy trình đó thành vài thao tác, và đó là lý do công cụ này nhanh chóng trở thành lựa chọn phổ biến cho việc chạy AI cục bộ.
Ví dụ so sánh dễ hiểu
Nếu từng dùng điện thoại, bạn sẽ quen với kho ứng dụng: tìm tên, bấm cài, mở ra dùng. Lập trình viên có khái niệm tương tự gọi là trình quản lý gói. Ollama được nhiều người ví như “trình quản lý gói cho mô hình AI”: chỉ cần một lệnh như ollama run gemma3, công cụ sẽ tự tải mô hình nếu chưa có, nạp vào bộ nhớ và mở ngay khung trò chuyện.
Mã nguồn mở, miễn phí cho dùng cục bộ, hỗ trợ macOS, Windows, Linux
Ollama phát hành theo giấy phép MIT, một trong những giấy phép mã nguồn mở thoáng nhất, cho phép dùng cả cho mục đích cá nhân lẫn thương mại. Việc chạy mô hình trên phần cứng của bạn hoàn toàn miễn phí và không giới hạn số lượt; chi phí thực sự chỉ là điện năng và phần cứng. Công cụ có bản cho macOS, Windows và Linux, kèm ảnh Docker chính thức cho máy chủ. Phần có tính phí duy nhất là Ollama Cloud, dịch vụ chạy mô hình trên hạ tầng của Ollama, sẽ được nói rõ ở phần sau.
Ollama không phải mô hình AI
Đây là điểm người mới hay nhầm nhất khi tìm hiểu Ollama là gì. Ollama không phải một mô hình như GPT hay Gemini, mà là công cụ để chạy các mô hình mở do nhiều tổ chức khác phát triển, như Llama của Meta, Gemma của Google, Mistral, Qwen của Alibaba hay DeepSeek. Chất lượng câu trả lời phụ thuộc vào mô hình bạn chọn, không phải vào Ollama. Nếu so sánh, Ollama giống chiếc đầu phát, còn mô hình là bộ phim bạn mở ra xem.
Một lưu ý nhỏ: trên mạng có bài giải thích tên Ollama là viết tắt của một cụm từ tiếng Anh dài. Không có nguồn chính thức nào xác nhận cách giải thích này, nên bạn không cần bận tâm.
Ollama hoạt động như thế nào?
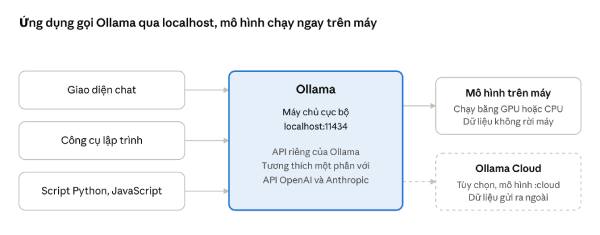
Về cơ bản, Ollama chạy như một dịch vụ nền trên máy tính. Mọi ứng dụng muốn dùng AI, từ giao diện chat đến công cụ lập trình, đều gửi yêu cầu đến dịch vụ này, và Ollama chuyển yêu cầu đến mô hình đang chạy trên phần cứng của bạn.
Tải mô hình về máy và chạy bằng một lệnh
Khi bạn gõ ollama run kèm tên mô hình, Ollama kiểm tra xem mô hình đã có trên máy chưa. Nếu chưa, nó tải từ thư viện trên trang chính thức về, lưu vào thư mục riêng, rồi nạp vào bộ nhớ GPU (VRAM) hoặc RAM. Từ lần thứ hai trở đi, mô hình đã có sẵn nên chỉ cần nạp lại. Sau một khoảng thời gian không dùng, Ollama tự giải phóng mô hình khỏi bộ nhớ để máy không bị chiếm tài nguyên mãi.
Mỗi mô hình trong thư viện thường có nhiều phiên bản theo kích thước, được đánh dấu bằng tag như gemma3:4b hay qwen3:14b. Con số đi kèm (4b, 14b) là số tham số tính bằng tỷ, và cũng là yếu tố quyết định máy bạn có chạy nổi hay không.
Mô hình lượng tử hóa giúp chạy được trên phần cứng hạn chế
Một mô hình 8 tỷ tham số ở dạng gốc có thể cần hơn 16GB bộ nhớ, vượt quá nhiều máy tính phổ thông. Để giải quyết, các mô hình trong thư viện Ollama thường được lượng tử hóa (quantization), hiểu nôm na là nén: mỗi tham số được lưu bằng ít bit hơn, chẳng hạn 4 bit thay vì 16 bit. Kích thước mô hình giảm còn khoảng một phần tư, đổi lại độ chính xác giảm nhẹ, thường khó nhận ra trong sử dụng hằng ngày. Giống như ảnh JPEG nhẹ hơn nhiều so với ảnh gốc mà vẫn đủ nét cho phần lớn nhu cầu.
Máy chủ cục bộ ở cổng 11434 và API để ứng dụng khác gọi vào
Khi đang chạy, Ollama mở một máy chủ nhỏ tại địa chỉ http://localhost:11434. Đây là cửa ngõ để mọi chương trình trên máy gửi yêu cầu: một giao diện chat, một tiện ích trong trình soạn code, hay một đoạn script của bạn. API của Ollama cho phép trò chuyện, tạo văn bản, tạo vector nhúng (embedding) và quản lý mô hình. Mặc định, máy chủ chỉ nghe kết nối từ chính máy đó, một chi tiết rất quan trọng về bảo mật sẽ được nói kỹ ở phần sau.
Tương thích một phần với API của OpenAI và Anthropic
Ngoài API riêng, Ollama còn cung cấp các điểm truy cập mô phỏng API của OpenAI và API Messages của Anthropic. Nhờ đó, nhiều công cụ vốn viết cho ChatGPT hay Claude có thể chuyển sang dùng mô hình cục bộ chỉ bằng cách đổi địa chỉ máy chủ. Tài liệu của Ollama còn hướng dẫn cấu hình Claude Code chạy với mô hình Ollama.
Cần nhấn mạnh chữ “một phần”. Theo tài liệu chính thức, một số tính năng chưa được hỗ trợ, chẳng hạn đếm token hay ép mô hình dùng một công cụ cụ thể trong lớp tương thích Anthropic. Khóa API được chấp nhận nhưng không được kiểm tra. Và quan trọng nhất, bạn đang dùng mô hình mở chạy trên máy mình, nên chất lượng sẽ khác với khi gọi mô hình gốc của OpenAI hay Anthropic. Lớp tương thích giúp kết nối dễ hơn, không phải một sự thay thế hoàn toàn.
Vì sao nên chạy AI cục bộ với Ollama?
Chạy AI cục bộ không phải lựa chọn dành cho tất cả mọi người, nhưng nó mang lại bốn lợi ích mà dịch vụ đám mây khó đáp ứng. Phần ưu nhược điểm bên dưới sẽ nói rõ cái giá phải trả cho những lợi ích này.
Quyền riêng tư: dữ liệu xử lý ngay trên máy
Khi chạy mô hình cục bộ, prompt và tài liệu của bạn không được gửi lên máy chủ của bất kỳ công ty nào. Đây là lý do chính khiến nhiều người tìm hiểu Ollama là gì: họ cần xử lý hợp đồng, dữ liệu khách hàng, mã nguồn nội bộ hay hồ sơ cá nhân mà không muốn, hoặc không được phép, đưa ra ngoài. Lưu ý rằng lợi ích này chỉ áp dụng cho mô hình cục bộ; mô hình đám mây của Ollama vẫn gửi dữ liệu ra ngoài.
Không tốn phí theo lượt dùng
Các API trả phí tính tiền theo số token, nên những tác vụ lặp lại hàng nghìn lần như phân loại email, tóm tắt tài liệu hàng loạt hay chạy thử nghiệm có thể đội chi phí rất nhanh. Chạy LLM trên máy tính của mình thì không có đồng hồ đếm token: bạn chỉ trả tiền phần cứng một lần và tiền điện. Với người đã có sẵn một máy đủ mạnh, chi phí tăng thêm gần như bằng không.
Dùng được khi không có mạng
Sau khi tải mô hình về, bạn có thể chạy mô hình AI offline hoàn toàn: trên máy bay, ở nơi sóng yếu, hay trong môi trường mạng bị cách ly vì lý do bảo mật. Bạn cũng không phụ thuộc vào tình trạng máy chủ của nhà cung cấp. Những ai từng gặp lỗi 1099 Gemini trong đợt sự cố diện rộng sẽ hiểu giá trị của một phương án dự phòng chạy ngay trên máy mình.
Tùy chỉnh và thử nhiều mô hình khác nhau
Với Ollama, bạn có thể tải và so sánh hàng chục mô hình mở, chuyển qua lại chỉ bằng một lệnh. Công cụ còn cho phép tạo biến thể riêng qua tệp cấu hình Modelfile: đặt sẵn lời nhắc hệ thống, điều chỉnh nhiệt độ (temperature), độ dài ngữ cảnh, rồi lưu lại dưới một tên mới. Đây là môi trường lý tưởng để học về cách các mô hình hoạt động mà không sợ hóa đơn cuối tháng.
Ollama chạy được những mô hình nào?
Thư viện của Ollama chứa hàng trăm mô hình mở, được chia thành vài nhóm chính theo khả năng:
- Mô hình ngôn ngữ: trò chuyện, viết, tóm tắt, dịch thuật và lập luận giải quyết bài toán phức tạp. Đặc biệt, người dùng có thể tìm hiểu thêm về bản chất AI suy luận là gì để chạy thử các mô hình reasoning mã nguồn mở như DeepSeek-R1 ngay trên máy, giúp giải toán và dò lỗi code qua chuỗi tư duy từng bước. Đây là nhóm lớn nhất.
- Mô hình đa phương thức (vision): đọc và mô tả hình ảnh, trích xuất chữ từ ảnh chụp, phân tích biểu đồ.
- Mô hình nhúng (embedding): chuyển văn bản thành vector để tìm kiếm theo ngữ nghĩa, là nền tảng cho các hệ thống hỏi đáp trên dữ liệu riêng (RAG).
- Mô hình gọi công cụ (tool calling): có thể yêu cầu chạy một hàm, tra cứu dữ liệu hay tương tác với phần mềm khác, phục vụ các ứng dụng dạng trợ lý tự động.
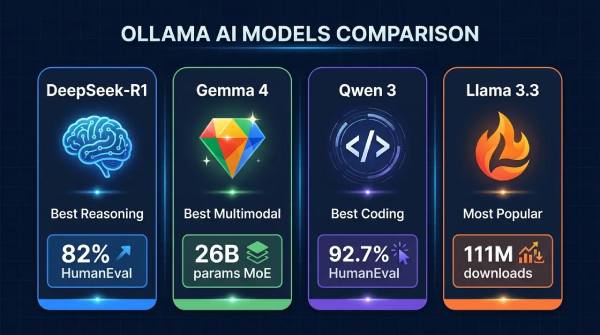
Các họ mô hình phổ biến gồm Llama của Meta, Gemma của Google, Qwen của Alibaba, Mistral, DeepSeek, Phi của Microsoft và gpt-oss, dòng mô hình trọng số mở của OpenAI. Nhiều họ có phiên bản chuyên biệt cho lập trình, như các bản “coder”. Danh sách này thay đổi liên tục khi có mô hình mới ra mắt, vì vậy cách tốt nhất là xem trực tiếp mục Models trên trang ollama.com, nơi mỗi mô hình có mô tả, các cỡ có sẵn và dung lượng tải về.
Cách chọn mô hình theo nhu cầu:
- Trò chuyện, viết lách hằng ngày: bắt đầu với mô hình đa dụng cỡ 4B đến 8B của các họ Gemma, Qwen hay Llama. Nếu cần tiếng Việt tốt, hãy thử vài mô hình với cùng một đoạn văn, vì khả năng tiếng Việt chênh lệch khá rõ giữa các họ.
- Viết code: chọn các bản chuyên lập trình. Mô hình lớn hơn thường xử lý tốt hơn những dự án nhiều tệp.
- Tóm tắt tài liệu dài: ưu tiên mô hình hỗ trợ ngữ cảnh dài, nhưng nhớ rằng ngữ cảnh càng dài càng tốn bộ nhớ.
- Hỏi đáp trên dữ liệu riêng: kết hợp một mô hình nhúng với một mô hình ngôn ngữ, thường qua các giao diện như Open WebUI có sẵn tính năng tải tài liệu lên.
Yêu cầu cấu hình để chạy LLM trên máy tính với Ollama
Bản thân Ollama rất nhẹ. Thứ quyết định máy bạn chạy nổi hay không là cỡ của mô hình. Nguyên tắc chung: toàn bộ mô hình cần nằm gọn trong bộ nhớ, lý tưởng nhất là VRAM của card đồ họa. Nếu không đủ, Ollama sẽ đẩy một phần sang RAM và CPU, và tốc độ giảm đáng kể.
| Cỡ mô hình | Bộ nhớ ước tính (bản nén phổ biến) | Phần cứng phù hợp | Phù hợp cho |
|---|---|---|---|
| ~1B–3B | Khoảng 8GB RAM | Laptop phổ thông, không cần GPU rời | Hỏi đáp đơn giản, thử nghiệm |
| 7B–8B | Khoảng 8GB VRAM hoặc 16GB RAM | GPU tầm trung, Mac 16GB | Trò chuyện, viết, tóm tắt hằng ngày |
| 12B–14B | Khoảng 16GB VRAM hoặc 32GB RAM | GPU cao cấp, Mac 32GB | Chất lượng tốt hơn rõ rệt, code cơ bản |
| 27B–32B | Khoảng 24GB VRAM trở lên | GPU 24GB, Mac 32GB–48GB | Lập trình, phân tích phức tạp |
| ~70B | Khoảng 64GB bộ nhớ | Mac Apple Silicon bộ nhớ lớn, máy nhiều GPU | Gần với mô hình thương mại ở nhiều tác vụ |
Cần hiểu đây là ước tính tham khảo tổng hợp từ nhiều nguồn, và các nguồn lệch nhau đôi chút. Con số thực tế phụ thuộc vào mức nén (bản 4 bit nhẹ hơn nhiều so với bản 8 bit), kiến trúc mô hình và đặc biệt là độ dài ngữ cảnh. Mỗi token trong ngữ cảnh đều chiếm thêm bộ nhớ, nên cùng một mô hình có thể chạy mượt với ngữ cảnh ngắn nhưng tràn bộ nhớ khi bạn nạp một tài liệu dài. Nếu chưa rõ khái niệm này, bài context window là gì giải thích chi tiết. Tài liệu của chính Ollama cũng lưu ý rằng một mô hình lập trình 30B cần ít nhất 24GB VRAM để chạy mượt, và cần nhiều hơn với ngữ cảnh dài.
Ngoài bộ nhớ, hãy chừa đủ dung lượng ổ cứng: một mô hình 7B–8B bản nén thường vào khoảng vài GB, còn bản 70B có thể vượt 40GB. Nếu thử nhiều mô hình, thư mục lưu trữ của Ollama phình to rất nhanh.
Vì sao Mac chip Apple Silicon chạy khá tốt?
Các máy Mac dùng chip M-series có kiến trúc bộ nhớ hợp nhất: CPU và GPU dùng chung một vùng bộ nhớ, thay vì tách RAM và VRAM như máy tính Windows dùng card rời. Nhờ đó, một chiếc Mac 64GB có thể dành phần lớn bộ nhớ cho GPU để chạy mô hình lớn, điều mà một card đồ họa tiêu dùng hiếm khi làm được vì dung lượng VRAM có hạn. Tốc độ sinh chữ của Mac có thể chậm hơn một card đồ họa cao cấp ở mô hình nhỏ, nhưng lợi thế về dung lượng giúp nó trở thành lựa chọn phổ biến để chạy các mô hình cỡ lớn.
Không có GPU thì sao?
Ollama vẫn chạy được hoàn toàn bằng CPU, nhưng tốc độ chậm hơn nhiều. Với mô hình nhỏ cỡ 1B–4B, một laptop phổ thông vẫn cho trải nghiệm chấp nhận được. Với mô hình 7B–8B, câu trả lời có thể hiện ra từng chữ chậm rãi. Trên 14B, chạy bằng CPU thường chỉ phù hợp cho tác vụ không cần phản hồi ngay, như xử lý hàng loạt qua đêm. Nếu máy yếu mà vẫn muốn dùng mô hình lớn, Ollama Cloud là phương án đáng cân nhắc.
Hướng dẫn cài đặt và dùng Ollama cơ bản
Phần này đi từ cài đặt đến gọi API. Các lệnh dưới đây dựa trên tài liệu chính thức tại thời điểm cập nhật; vì Ollama cập nhật rất thường xuyên, tên mô hình hay tuỳ chọn có thể thay đổi nhẹ.
Cài đặt trên Windows, macOS, Linux
Windows và macOS: tải bộ cài từ trang ollama.com/download và cài như phần mềm thông thường. Sau khi cài, Ollama chạy nền và có biểu tượng trên thanh hệ thống (Windows) hoặc thanh menu (macOS), kèm ứng dụng chat có giao diện đồ họa.
Linux: chạy lệnh cài đặt chính thức trong Terminal:
curl -fsSL https://ollama.com/install.sh | sh
Docker: Ollama có ảnh chính thức ollama/ollama cho máy chủ. Khi ánh xạ cổng, nên ghi rõ 127.0.0.1 để cổng 11434 không bị mở ra mạng ngoài:
docker run -d -v ollama:/root/.ollama -p 127.0.0.1:11434:11434 –name ollama ollama/ollama
Kiểm tra cài đặt thành công bằng lệnh ollama –version.
Chạy mô hình đầu tiên bằng lệnh ollama run
Mở Terminal (macOS, Linux) hoặc PowerShell (Windows) và gõ:
ollama run gemma3
Lần đầu, Ollama sẽ tải mô hình về (mất vài phút tùy tốc độ mạng). Khi thấy dấu nhắc >>>, bạn có thể gõ câu hỏi bằng tiếng Việt và nhấn Enter. Gõ /bye để thoát. Nếu máy có cấu hình khiêm tốn, hãy chọn cỡ nhỏ hơn bằng cách thêm tag, ví dụ ollama run gemma3:1b.
Các lệnh quản lý hay dùng
| Lệnh | Tác dụng |
|---|---|
| ollama pull <tên> | Tải mô hình về mà chưa chạy |
| ollama list | Xem danh sách mô hình đã tải và dung lượng |
| ollama ps | Xem mô hình đang nạp trong bộ nhớ, chạy bằng GPU hay CPU |
| ollama stop <tên> | Giải phóng mô hình khỏi bộ nhớ |
| ollama rm <tên> | Xóa mô hình khỏi ổ cứng |
| ollama show <tên> | Xem thông tin chi tiết của mô hình |
Lệnh ollama ps đặc biệt hữu ích: nếu cột bộ xử lý cho thấy một phần mô hình đang chạy trên CPU, đó là dấu hiệu mô hình quá lớn so với VRAM và bạn nên chọn cỡ nhỏ hơn.
Dùng giao diện đồ họa thay cho dòng lệnh
Nếu không quen dòng lệnh, ứng dụng desktop của Ollama trên macOS và Windows có sẵn khung chat: chọn mô hình từ danh sách, gõ câu hỏi, kéo thả tệp vào để hỏi về nội dung. Ngoài ra còn có nhiều giao diện bên thứ ba kết nối với Ollama, phổ biến nhất là Open WebUI, một giao diện web giống ChatGPT hỗ trợ nhiều người dùng, lưu lịch sử, tải tài liệu lên để hỏi đáp.
Gọi Ollama bằng API hoặc thư viện Python, JavaScript
Với lập trình viên, cách nhanh nhất là gọi thẳng API bằng curl:
curl http://localhost:11434/api/chat -d ‘{“model”: “gemma3”, “messages”: [{“role”: “user”, “content”: “Xin chào”}], “stream”: false}’
Hoặc dùng thư viện Python chính thức (pip install ollama):
from ollama import chat
response = chat(model=’gemma3′, messages=[{‘role’: ‘user’, ‘content’: ‘Giải thích Ollama trong một câu’}])
print(response.message.content)
Ollama cũng có thư viện JavaScript chính thức với cách dùng tương tự. Nếu ứng dụng của bạn đã viết cho thư viện của OpenAI, chỉ cần đổi địa chỉ gốc thành http://localhost:11434/v1 và điền một khóa API bất kỳ.
Ollama Cloud: dùng mô hình lớn khi máy không đủ mạnh
Một hạn chế lớn của việc chạy AI cục bộ là phần cứng: các mô hình mở mạnh nhất hiện nay có hàng trăm tỷ tham số, vượt xa khả năng của máy tính cá nhân. Ollama Cloud ra đời để lấp khoảng trống này, và đây cũng là phần mà nhiều bài giới thiệu cũ về Ollama chưa đề cập.
Mô hình đám mây là gì
Mô hình đám mây của Ollama được chạy trên GPU của Ollama, nhưng bạn dùng chúng qua đúng lệnh và API như mô hình cục bộ. Sau khi đăng nhập bằng lệnh ollama signin, bạn chỉ cần chọn một mô hình có hậu tố đám mây, thường là :cloud hoặc -cloud, rồi chạy như bình thường. Với ứng dụng đang gọi localhost:11434, không cần sửa gì thêm: Ollama tự chuyển yêu cầu lên đám mây. Cách làm này cho phép dùng mô hình cỡ lớn trên cả một chiếc laptop mỏng nhẹ, hoặc kết hợp: mô hình nhỏ chạy cục bộ cho việc thường ngày, mô hình lớn trên đám mây cho việc khó.
Danh sách mô hình đám mây thay đổi thường xuyên; một số mô hình từng bị thay thế hoặc ngừng hỗ trợ khi có phiên bản mới. Hãy xem mục Cloud trên trang ollama.com trước khi xây dựng quy trình dựa vào một mô hình cụ thể.
Gói miễn phí và các gói trả phí
Cần tách bạch hai thứ: chạy mô hình trên máy của bạn luôn miễn phí và không giới hạn, còn Ollama Cloud có hệ thống gói riêng. Tại thời điểm cập nhật, theo trang giá của Ollama, gói miễn phí chỉ có một lượng dùng thử nhỏ với nhóm mô hình khởi đầu và cho phép một yêu cầu tại một thời điểm. Các gói trả phí gồm Pro khoảng 20 USD mỗi tháng và Max khoảng 100 USD mỗi tháng, có hạn mức sử dụng lớn hơn và cho phép nhiều yêu cầu chạy song song hơn; ngoài ra còn có gói cho nhóm và doanh nghiệp.
Cách tính phí của Ollama Cloud đã thay đổi nhiều lần trong năm 2026: từ hạn mức theo phiên và theo tuần chuyển sang tín dụng sử dụng tính theo token từ cuối tháng 8/2026. Vì vậy, hãy xem trang ollama.com/pricing để biết giá và hạn mức chính xác trước khi đăng ký.
Lưu ý khi dùng mô hình đám mây
Quan trọng nhất: khi dùng mô hình đám mây, prompt và dữ liệu của bạn rời khỏi máy để được xử lý trên hạ tầng của Ollama. Bạn mất đi lợi thế riêng tư tuyệt đối, lý do chính khiến nhiều người chọn Ollama ngay từ đầu. Với dữ liệu nhạy cảm, hãy đọc chính sách dữ liệu của Ollama hoặc chỉ dùng mô hình cục bộ. Ngoài ra, một số tính năng nâng cao như đầu ra có cấu trúc có thể chưa được hỗ trợ đầy đủ trên một số mô hình đám mây.
Lưu ý bảo mật khi chạy AI cục bộ với Ollama
Chạy AI cục bộ thường được xem là an toàn hơn, nhưng có một điểm dễ bị bỏ qua và ít bài tiếng Việt nhắc đến: API của Ollama mặc định không yêu cầu xác thực. Bất kỳ ai gửi được yêu cầu đến cổng 11434 đều có thể dùng mô hình của bạn, tải thêm mô hình mới hay xóa mô hình đã có.
Không mở cổng 11434 ra Internet. Mặc định, Ollama chỉ nghe kết nối từ chính máy (127.0.0.1), nên an toàn. Rủi ro xuất hiện khi bạn đổi biến môi trường OLLAMA_HOST thành 0.0.0.0 để máy khác truy cập, ánh xạ cổng Docker không giới hạn địa chỉ, hoặc cài Ollama trên máy chủ đám mây mà quên cấu hình tường lửa. Các nhà nghiên cứu bảo mật đã nhiều lần cảnh báo về số lượng lớn máy chủ Ollama bị phơi ra Internet mà không có bảo vệ, cho phép người lạ dùng miễn phí tài nguyên GPU của chủ máy.
Nếu cần truy cập từ xa, hãy thêm lớp xác thực. Các cách phổ biến gồm đặt Ollama sau một reverse proxy (như Nginx hay Caddy) có yêu cầu đăng nhập hoặc khóa API, hoặc chỉ truy cập qua mạng riêng ảo như VPN hay Tailscale. Với Open WebUI, hãy bật tài khoản đăng nhập và để Ollama chỉ giao tiếp nội bộ với giao diện này.
Chỉ tải mô hình từ nguồn đáng tin. Ngoài thư viện chính thức, Ollama cho phép tải mô hình do cộng đồng chia sẻ. Một mô hình có thể đi kèm lời nhắc hệ thống hoặc cấu hình không như bạn mong đợi. Hãy ưu tiên mô hình từ thư viện chính thức hoặc từ nhà phát triển có uy tín, và dùng ollama show để xem cấu hình trước khi dùng.
Giữ Ollama luôn cập nhật. Các bản cập nhật thường đi kèm bản vá bảo mật, đặc biệt quan trọng nếu bạn chạy Ollama trên máy chủ dùng chung.
Ollama so với ChatGPT, Gemini và các công cụ chạy AI cục bộ khác
Sau khi hiểu Ollama là gì, câu hỏi thực tế nhất là: khi nào nên dùng nó thay vì một dịch vụ đám mây quen thuộc, và nó khác gì các công cụ chạy AI cục bộ khác?
Ollama so với dịch vụ đám mây như ChatGPT, Gemini
| Tiêu chí | Ollama (mô hình cục bộ) | ChatGPT, Gemini |
|---|---|---|
| Quyền riêng tư | Dữ liệu không rời máy | Dữ liệu xử lý trên máy chủ nhà cung cấp |
| Chi phí | Miễn phí phần mềm, tốn phần cứng và điện | Gói miễn phí giới hạn, gói trả phí theo tháng hoặc theo token |
| Chất lượng | Phụ thuộc mô hình và phần cứng; mô hình nhỏ thường kém hơn | Mô hình hàng đầu, thường mạnh nhất ở tác vụ khó |
| Tính năng đi kèm | Tự lắp ghép qua giao diện bên thứ ba | Tìm kiếm web, tạo ảnh, ghi nhớ, tích hợp sẵn |
| Dùng khi mất mạng | Có | Không |
| Độ tiện lợi | Cần cài đặt, chọn mô hình, quản lý phần cứng | Mở trình duyệt là dùng được |
Tóm lại, dịch vụ đám mây thắng về chất lượng và sự tiện lợi, còn Ollama thắng về quyền kiểm soát, quyền riêng tư và chi phí cho tác vụ lặp lại.
Ollama so với LM Studio, llama.cpp
llama.cpp là một dự án mã nguồn mở viết bằng C/C++ để chạy mô hình ngôn ngữ hiệu quả trên phần cứng phổ thông. Nó mạnh và linh hoạt nhưng thiên về kỹ thuật, phù hợp với người muốn tự tinh chỉnh từng tham số. Ollama ban đầu xây dựng dựa trên llama.cpp và bổ sung lớp quản lý mô hình, API và trải nghiệm “một lệnh là chạy”; về sau, Ollama cũng phát triển thêm engine riêng cho một số mô hình.
LM Studio là ứng dụng desktop tập trung vào giao diện đồ họa: duyệt và tải mô hình, trò chuyện, chỉnh tham số bằng thanh trượt, và cũng có chế độ máy chủ cục bộ cho ứng dụng khác gọi vào. LM Studio thường được xem là thân thiện hơn với người không quen dòng lệnh, trong khi Ollama được ưa chuộng khi cần tích hợp vào phần mềm, chạy trên máy chủ hay tự động hóa. Tính năng của cả hai thay đổi nhanh, nên bạn nên dùng thử trước khi quyết định.
Trong thực tế, nhiều người dùng song song cả hai thế giới: Ollama cho dữ liệu riêng tư, tác vụ lặp lại và thử nghiệm; ChatGPT, Gemini hay Claude cho những việc cần mô hình mạnh nhất, tìm kiếm web hay tính năng tích hợp sẵn.
Ưu điểm và hạn chế của Ollama
Ollama là một trong những cách dễ nhất để bắt đầu chạy mô hình AI offline, nhưng không phải công cụ hoàn hảo. Dưới đây là bức tranh cân bằng.
| Ưu điểm | Hạn chế |
|---|---|
| Cài đặt đơn giản, một lệnh là chạy được mô hình | Cần phần cứng đủ mạnh, đặc biệt là VRAM hoặc bộ nhớ lớn |
| API có sẵn, dễ tích hợp vào ứng dụng | Mô hình nhỏ chạy cục bộ thường kém mô hình lớn trên đám mây |
| Miễn phí và không giới hạn khi chạy cục bộ | Tương thích API OpenAI, Anthropic chỉ một phần |
| Thư viện mô hình mở phong phú, cập nhật liên tục | API mặc định không có xác thực, cần tự bảo vệ khi mở ra mạng |
| Dữ liệu không rời máy, dùng được khi mất mạng | Thiếu các tính năng tích hợp sẵn như tìm kiếm web, ghi nhớ |
| Có lựa chọn Ollama Cloud cho mô hình lớn | Mô hình vẫn có thể bịa thông tin như mọi LLM khác |
Điểm cuối cùng trong cột hạn chế đáng được nhấn mạnh: chạy cục bộ bảo vệ dữ liệu của bạn, nhưng không làm mô hình trở nên chính xác hơn. Mô hình càng nhỏ thì khả năng tạo ra thông tin sai càng cao, nhất là với kiến thức hiếm và sự kiện mới. Bạn có thể đọc thêm về hiện tượng này trong bài AI hallucination là gì.
Ollama dùng để làm gì? Một số ứng dụng thực tế
Hiểu Ollama là gì chỉ là bước đầu; giá trị thật sự nằm ở cách bạn đưa nó vào công việc. Dưới đây là năm hướng sử dụng phổ biến.
Trò chuyện và hỏi đáp riêng tư. Nhờ AI góp ý về một email nhạy cảm, soạn thư xin việc có thông tin cá nhân, hay suy nghĩ thành lời về một vấn đề riêng tư mà không lo nội dung bị lưu trên máy chủ của bên khác.
Hỗ trợ viết code. Kết nối Ollama với trình soạn code qua các tiện ích hỗ trợ máy chủ cục bộ để có gợi ý code, giải thích đoạn mã hay viết hàm kiểm thử, phù hợp với dự án có mã nguồn không được phép gửi ra ngoài. Như đã nói, tài liệu của Ollama còn hướng dẫn dùng mô hình cục bộ làm nền cho Claude Code qua lớp tương thích Anthropic.
Tóm tắt và tra cứu tài liệu nội bộ. Kết hợp một mô hình nhúng và một mô hình ngôn ngữ để hỏi đáp trên kho tài liệu của công ty, như quy trình, hợp đồng mẫu hay tài liệu kỹ thuật, mà toàn bộ dữ liệu vẫn nằm trên máy chủ nội bộ.
Chatbot nội bộ doanh nghiệp. Triển khai Ollama trên một máy chủ có GPU, đặt Open WebUI phía trước với tài khoản đăng nhập cho nhân viên. Cách này phù hợp với tổ chức có yêu cầu chặt chẽ về dữ liệu, miễn là tuân thủ các lưu ý bảo mật đã nêu.
Thử nghiệm và học tập về AI. Sinh viên và lập trình viên có thể so sánh hành vi của nhiều mô hình, thử thay đổi temperature, độ dài ngữ cảnh hay lời nhắc hệ thống, hoặc xây dựng ứng dụng AI đầu tiên mà không tốn chi phí API.
Câu hỏi thường gặp về Ollama
Ollama là gì?
Ollama là công cụ mã nguồn mở (giấy phép MIT) giúp tải và chạy mô hình ngôn ngữ lớn ngay trên máy tính của bạn, qua dòng lệnh, ứng dụng desktop hoặc API cục bộ. Ollama không phải mô hình AI, mà là công cụ để chạy các mô hình mở như Llama, Gemma, Qwen hay Mistral.
Ollama có miễn phí không?
Có, với việc chạy mô hình trên máy của bạn: không tốn phí và không giới hạn lượt dùng. Riêng Ollama Cloud có gói miễn phí với hạn mức nhỏ và các gói trả phí; giá cụ thể nên xem trên trang chính thức vì thay đổi thường xuyên.
Ollama có chạy được khi không có mạng không?
Có. Sau khi đã tải mô hình về, bạn có thể dùng mô hình cục bộ hoàn toàn offline. Chỉ mô hình đám mây và việc tải mô hình mới mới cần Internet.
Máy yếu có dùng Ollama được không?
Được, nếu chọn mô hình phù hợp. Máy có khoảng 8GB RAM vẫn chạy được mô hình cỡ 1B–3B cho tác vụ đơn giản. Với mô hình lớn hơn, bạn có thể cân nhắc Ollama Cloud.
Ollama có cần GPU không?
Không bắt buộc. Ollama chạy được bằng CPU, nhưng chậm hơn nhiều. GPU có VRAM lớn hoặc Mac chip Apple Silicon sẽ cho trải nghiệm mượt hơn rõ rệt.
Ollama an toàn không?
Với cấu hình mặc định, Ollama chỉ nhận kết nối từ chính máy nên khá an toàn. Rủi ro xuất hiện khi mở cổng 11434 ra mạng mà không có xác thực, vì API mặc định không yêu cầu đăng nhập. Hãy chỉ tải mô hình từ nguồn đáng tin.
Ollama khác ChatGPT thế nào?
ChatGPT là dịch vụ đám mây dùng mô hình của OpenAI, chạy trên máy chủ của họ. Ollama là công cụ chạy mô hình mở trên máy của bạn. ChatGPT thường mạnh hơn và tiện hơn; Ollama riêng tư hơn, không tốn phí theo lượt và dùng được khi mất mạng.
Làm sao xóa mô hình đã tải để giải phóng dung lượng?
Dùng lệnh ollama list để xem các mô hình và dung lượng, sau đó chạy ollama rm <tên mô hình> để xóa. Ví dụ: ollama rm gemma3.
Kết luận
Vậy Ollama là gì? Đó là cách đơn giản nhất hiện nay để chạy AI trên máy tính cá nhân: một lệnh để tải và trò chuyện với mô hình, kèm API sẵn sàng cho mọi ứng dụng. Để dùng hiệu quả, hãy chọn cỡ mô hình phù hợp với bộ nhớ của máy, đừng mở cổng API ra Internet khi chưa có xác thực, và nhớ rằng mô hình đám mây không còn riêng tư tuyệt đối. Ollama không thay thế hoàn toàn ChatGPT hay Gemini, nhưng là một mảnh ghép rất giá trị khi bạn cần quyền riêng tư và quyền kiểm soát. Để hiểu sâu hơn về cách mô hình vận hành, bạn có thể đọc thêm các bài context window và AI hallucination là gì. Các hướng dẫn và đánh giá công cụ AI mới nhất luôn có tại Orbitaltech.