Thinking Machines Lab, công ty AI do Mira Murati dẫn dắt, vừa ra mắt Inkling 2 Mini, mô hình AI trọng số mở (open-weight) với 26 tỷ tham số. Mô hình cho hiệu năng ấn tượng ở các tác vụ lập trình, suy luận và agent. Điểm đáng chú ý nhất là Inkling 2 Mini có thể chạy hoàn toàn offline trên phần cứng phổ thông, kể cả MacBook có 32GB bộ nhớ hợp nhất. Bí quyết nằm ở kiến trúc looped transformer độc đáo, cho phép mô hình “suy nghĩ” nhiều hơn mà không cần thêm bộ nhớ. Cùng orbitaltech.net tìm hiểu chi tiết.
Inkling 2 Mini là gì?
Được công bố ngày 20/11, Inkling 2 Mini là phiên bản nhỏ gọn hơn nhiều so với Inkling 2 Small có tới 594 tỷ tham số. Trên X, Thinking Machines cho biết mô hình mới là lời đáp cho phản hồi rằng Inkling 2 Small quá lớn. Người dùng muốn một mô hình nhỏ gọn để tự chạy trên máy của mình.
Inkling 2 Mini là mô hình đa phương thức, nhận đầu vào văn bản và hình ảnh, xuất ra văn bản. Mô hình được thiết kế cho hệ thống agent, sử dụng công cụ, trợ lý lập trình, chatbot và RAG. Mô hình phát hành theo giấy phép Apache 2.0, với trọng số tải về trên Hugging Face, chạy local qua Ollama, đồng thời có thể suy luận và tinh chỉnh trên nền tảng Tinker của Thinking Machines.
Ngay từ ngày đầu, Inkling 2 Mini đã được hỗ trợ trên SGLang, vLLM, Ollama, Unsloth, NVIDIA Dynamo và TokenSpeed, cùng các công cụ tinh chỉnh RL như SkyRL, Miles và NVIDIA AutoModel.
Kiến trúc looped transformer: “suy nghĩ lâu hơn” mà không tốn thêm bộ nhớ
Theo thông báo kỹ thuật chính thức, Inkling 2 Mini dùng kiến trúc Mixture of Experts (MoE) 24 lớp, với 26,4 tỷ tham số tổng và chỉ 3,4 tỷ tham số hoạt động. Bên trong mỗi lớp có 128 khối chuyên gia (expert), nhưng mỗi token chỉ được định tuyến tới 8 khối trong số đó.
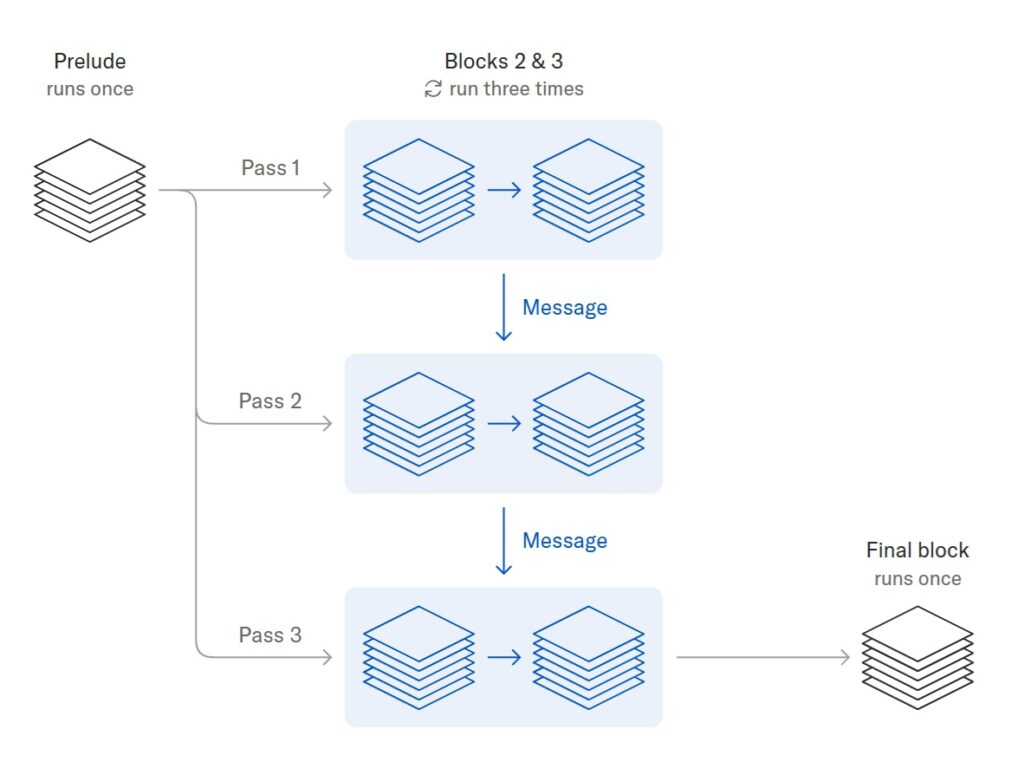
Điểm khác biệt nằm ở cách xử lý thông tin. Thay vì cho mỗi token đi qua từng lớp một lần, 12 lớp giữa được chạy ba lần, còn sáu lớp đầu và sáu lớp cuối chỉ chạy một lần. Nhờ vậy, mô hình thực hiện 48 lượt xử lý lớp cho mỗi token dù chỉ lưu trọng số của 24 lớp. Số tham số hoạt động hiệu dụng vì thế tăng lên 5,4 tỷ mỗi token. Nói đơn giản, Inkling 2 Mini có thể dành thêm thời gian suy luận nội bộ trước khi tạo ra token tiếp theo.
Thinking Machines huấn luyện mô hình trên nền tảng NVIDIA GB300 Grace Blackwell Ultra, tận dụng định dạng NVFP4 được tăng tốc phần cứng. Phần lớn trọng số được huấn luyện ở độ chính xác 4-bit NVFP4, riêng bốn lớp cuối dùng 8-bit MXFP8. Vì trọng số được triển khai đúng ở độ chính xác lúc huấn luyện, công ty cho biết mô hình tránh được tổn thất do lượng tử hóa sau huấn luyện.
Hiệu năng Inkling 2 Mini trên các bài benchmark
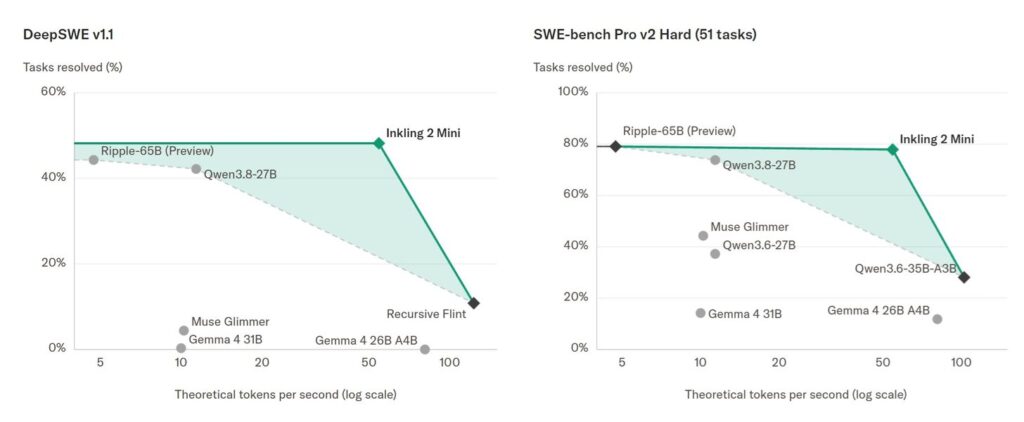
Thinking Machines công bố Inkling 2 Mini dẫn đầu mọi mô hình trọng số mở dưới 100 tỷ tham số trên DeepSWE v1.1 và Vals Index v2.2. Mô hình đạt điểm ngang Qwen3.8-27B (20,1) trên Artificial Analysis Index. Một số kết quả nổi bật:
- SWE-bench Verified: 79,2%
- SWE-bench Pro v2 Hard: 77,9% (Qwen3.8-27B: 73,8%)
- DeepSWE v1.1: 48,2% (Qwen3.8-27B: 42,2%)
- Vals Index v2.2: 46,5%
- Artificial Analysis Intelligence Index: 20,1
- Điểm yếu: HLE-Diamond 15,2%, MultiChallenge 50,0%
Đánh giá độc lập của Artificial Analysis cho thấy Inkling 2 Mini đạt điểm tương đương Qwen3.8 27B và Nanbeige4.3-33B, nhưng dùng ít hơn khoảng 5 và 6 lần tham số hoạt động. Mô hình rẻ hơn khoảng 6 lần và nhanh hơn khoảng 4 lần mỗi tác vụ so với Qwen3.8 27B. Dù vậy, cần lưu ý phần lớn benchmark là số liệu tự công bố, và cộng đồng cũng tỏ ra thận trọng với tuyên bố “vượt Qwen” khi tự kiểm tra thực tế.
Chạy offline trên MacBook 32GB, hỗ trợ ngữ cảnh 1 triệu token
Điểm hấp dẫn nhất của Inkling 2 Mini là khả năng tiếp cận. Mô hình chỉ chiếm khoảng 20GB bộ nhớ, đủ để chạy trên Mac dùng chip Apple Silicon có từ 32GB bộ nhớ hợp nhất thông qua Ollama. Máy tính AI để bàn NVIDIA DGX Spark cũng được hỗ trợ chính thức. Với GPU khác, nên có từ 32GB VRAM trở lên. Mô hình hỗ trợ cửa sổ ngữ cảnh lên tới 1 triệu token.
Để minh họa, Thinking Machines cho Inkling 2 Mini chạy hoàn toàn offline trên MacBook Pro M5 Pro 48GB. Trong một chuyến bay, mô hình được cho là đã tạo ra một game mô phỏng bay chơi được chỉ trong vài phút. Ở một demo khác, Inkling 2 Mini điều khiển toàn bộ 20 dân làng tự hành trong thị trấn pixel Thinkyville. Các nhân vật tự lên kế hoạch cho ngày của mình, tương tác với nhau và phản hồi tin nhắn của người chơi, tất cả chạy offline trên một chiếc MacBook Pro.
Câu hỏi về tính minh bạch và an toàn AI
Kiến trúc looped transformer cũng đặt ra một câu hỏi quan trọng về an toàn và minh bạch. Vì mô hình có thể tính toán thêm ở bên trong mà không viết ra từng bước suy luận, các nhà nghiên cứu lo ngại hành vi của nó sẽ khó giám sát hơn.
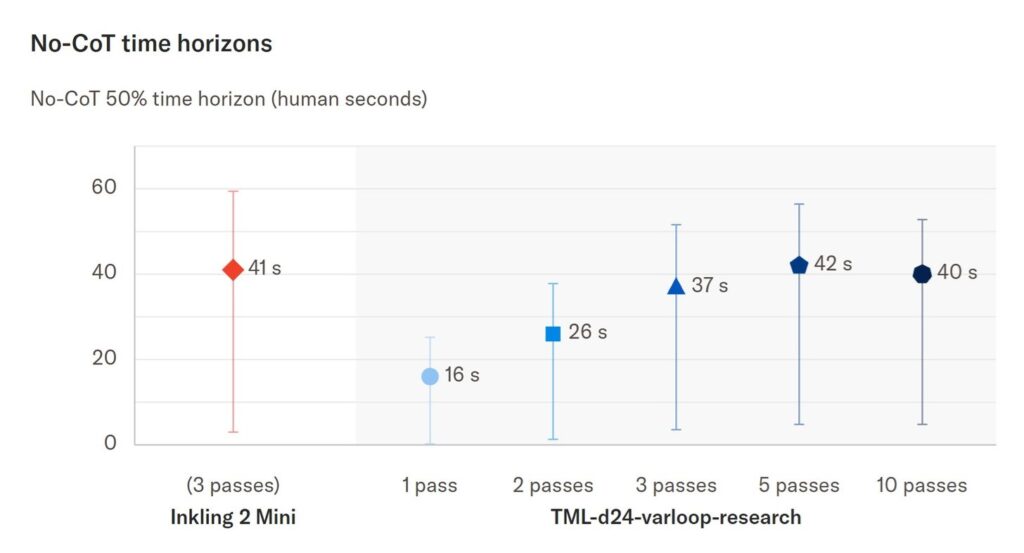
Thinking Machines đã kiểm chứng điều này bằng một mô hình nghiên cứu riêng với số vòng lặp thay đổi được. Kết quả cho thấy càng nhiều lượt lặp, mô hình càng giải được nhiều bài toán mà không cần viết chuỗi suy luận (chain of thought). Thời gian tác vụ mà mô hình xử lý được khi không viết ra suy luận tăng từ 16 giây với một lượt lên 37 giây với ba lượt.
Tuy nhiên, thử nghiệm cũng cho thấy phần suy luận được viết ra vẫn dễ hiểu, và khả năng giám sát không bị suy giảm đáng kể ở quy mô này. Công ty cũng thừa nhận mô hình còn hạn chế, như kém hơn ở các cuộc hội thoại nhiều lượt phức tạp và những yêu cầu có nhiều ràng buộc.
Inkling 2 Mini cho thấy một hướng đi thú vị trong cuộc đua AI: thay vì chỉ tăng số tham số, Thinking Machines tận dụng kiến trúc looped transformer để mô hình suy luận sâu hơn mà vẫn đủ nhỏ để chạy trên laptop. Với giấy phép Apache 2.0, khả năng chạy offline trên MacBook 32GB và điểm lập trình ấn tượng, Inkling 2 Mini là lựa chọn đáng cân nhắc cho lập trình viên muốn chạy AI agent ngay trên máy của mình. Dù vậy, người dùng vẫn nên chờ thêm các đánh giá độc lập để có cái nhìn khách quan hơn về hiệu năng thực tế.